Podrobný návod, jak napsat životopis: Data Scientist
Prohlédněte si tento vzor životopisu na pozici data scientist a pak si s AI vytvořte verzi přizpůsobenou konkrétní pozici, nebo zjistěte skóre svého současného životopisu.
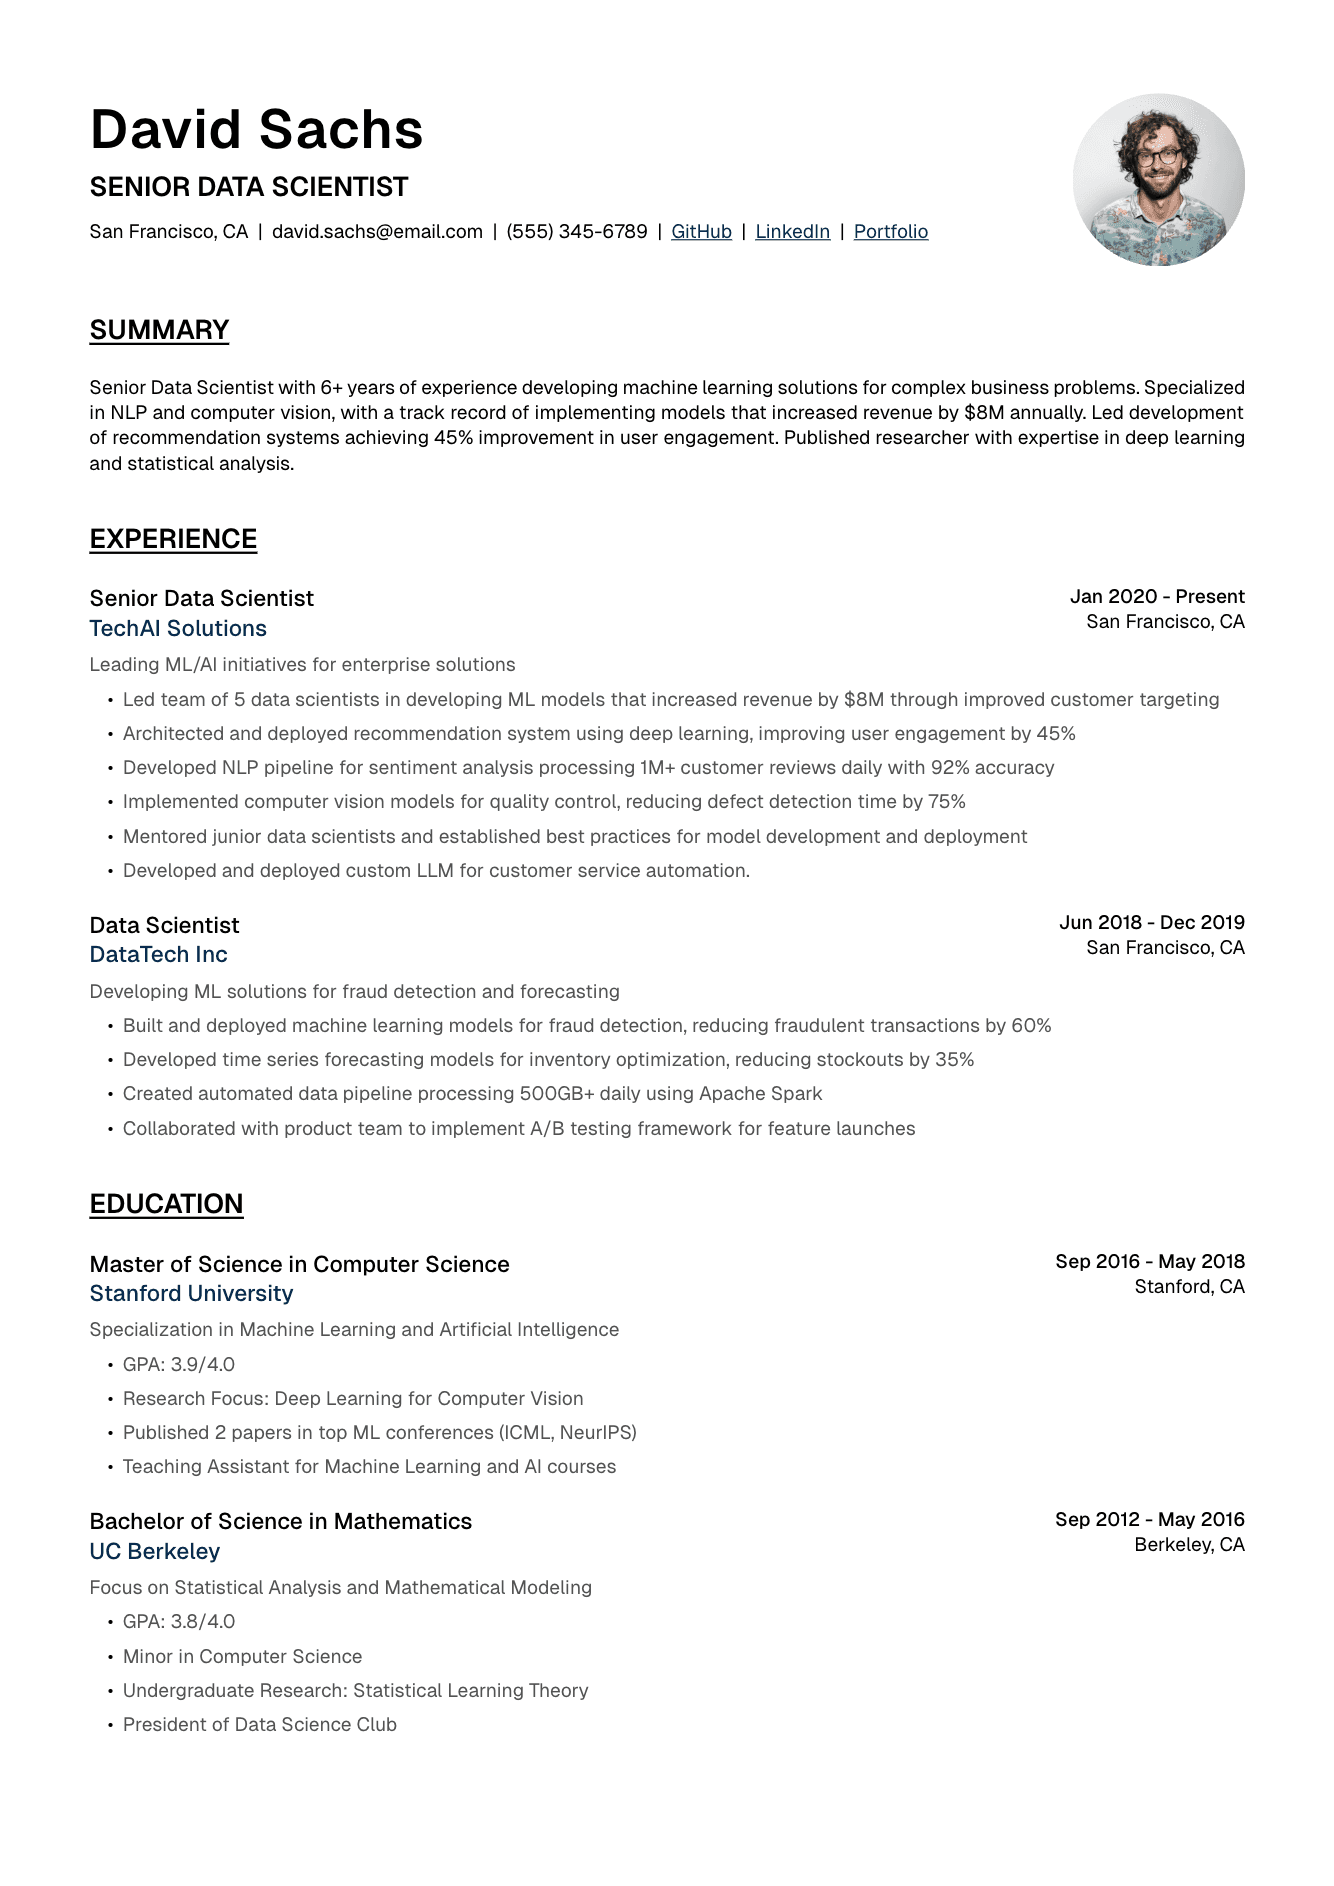
Profesní profil pro datové vědce
Profesní profil datového vědce by měl vyvážit technické znalosti a obchodní myšlení a hned ukázat, že ze složitých dat umíte získat využitelné poznatky. Tato sekce musí zaujmout vašimi nejvýznamnějšími projekty, zkušenostmi s modelováním a prokázaným přínosem pro firmu. U seniorních pozic zdůrazněte nasazené systémy strojového učení a vedené týmy, u pozic se středními zkušenostmi úspěšné modely a analýzy, u pozic pro začátečníky pevné teoretické základy a praktické projekty. Vyčíslete úspěchy konkrétními čísly a pište jasně. Tuto sekci přizpůsobte konkrétní pozici a oboru a zdůrazněte relevantní domény a technické specializace. Profil by neměl ukázat jen vaše technické schopnosti, ale i to, jak vaše analýzy a modely ovlivnily obchodní rozhodnutí a přinesly zlepšení.
Profil seniorního datového vědce
U seniorních pozic by profil měl zdůraznit tři věci: technické vedení ve strojovém učení, odpovědnost za projekty od začátku do konce a přínos pro byznys. Zaměřte se na modely nasazené do produkce, vedené týmy a konkrétní dosažená zlepšení.
Senior Data Scientist s více než 8 lety praxe ve vývoji a nasazování řešení strojového učení ve velkém měřítku. Vedl vývoj doporučovacího systému, který díky vyššímu zapojení uživatelů přinesl přes 50 mil. USD dodatečných tržeb. Expert na deep learning a NLP s prokazatelnými výsledky v mentorování týmů a zavádění postupů MLOps, které zkrátily nasazení modelů o 70 %.
Principal Data Scientist se specializací na počítačové vidění a deep learning. Více než 10 let praxe ve vedení AI iniciativ ve velkém měřítku, včetně vývoje systému pro detekci objektů v reálném čase, který denně zpracuje přes 1 mil. obrázků s přesností 98 %. Znalost PyTorch, TensorFlow a distribuovaného trénování, díky které snížil náklady na trénování modelů o 300 tis. USD ročně.
Začněte nejvyšší pozicí a počtem let praxe
Uveďte konkrétní oblasti ML a technologie, ve kterých vynikáte
Vyčíslete přínos konkrétními čísly (růst tržeb, zlepšení přesnosti)
Zdůrazněte úspěchy v produktu i ve vedení
Pro dobrou čitelnost se vejděte do 4 řádků
Profil datového vědce se středními zkušenostmi
Datoví vědci se středními zkušenostmi by se měli zaměřit na úspěšné projekty a rostoucí technické znalosti. Ukažte, že máte projekty na starosti od začátku do konce, a uveďte konkrétní technické problémy, které jste vyřešili.
Data Scientist se 4 lety praxe ve vývoji řešení strojového učení pro finanční služby. Navrhl a nasadil model pro odhalování podvodů, který denně zpracuje transakce za více než 100 mil. USD s přesností 99,5 %. Díky inovativnímu feature engineeringu a ensemble modelům snížil počet falešně pozitivních výsledků o 40 %.
Machine Learning Engineer se 3 lety praxe se specializací na NLP a analýzu textu. Vedl vývoj pipeline pro analýzu sentimentu, která měsíčně zpracuje přes 1 mil. zákaznických recenzí s přesností 92 %. Díky distribuovanému trénování a automatickému výběru příznaků zrychlil trénování modelů 5×.
Profil datového vědce pro začátečníky
U pozic pro začátečníky se zaměřte na vzdělání, stáže a projekty. Zdůrazněte pevné teoretické základy a praktické použití.
Absolvent datové vědy s pevnými základy ve strojovém učení, statistice a softwarovém inženýrství. Absolvoval 2 stáže v technologických firmách, kde vyvíjel a nasazoval ML modely v Pythonu, TensorFlow a AWS. Aktivní soutěžící na Kaggle se 3 medailemi ze soutěží a publikovaným výzkumem ve zpracování přirozeného jazyka.
Čerstvý absolvent magisterského studia datové vědy s praktickými zkušenostmi se strojovým učením z několika výzkumných projektů a stáží. Vyvinul model pro predikci odchodu zákazníků s přesností 85 %, který má podle odhadu ušetřit 200 tis. USD ročně. Ovládá Python, R a SQL a prokazatelně se rychle učí nové technologie.
Zdůrazněte relevantní předměty a výzkumné projekty
Uveďte stáže a svůj konkrétní přínos
Předveďte úspěchy v soutěžích a osobní projekty
Ukažte chuť se neustále učit
Uveďte konkrétní technologie a ML frameworky, se kterými jste pracovali
Vytvořte si takový životopis na pozici data scientist
Vezměte tento vzor jako výchozí bod a pak přizpůsobte obsah, klíčová slova a rozvržení popisu pozice, o kterou se ucházíte.
Sekce technických dovedností
Sekce technických dovedností datového vědce musí ukázat šíři i hloubku znalostí ve strojovém učení, statistice a programování a zároveň být čitelná pro ATS. Seřaďte dovednosti podle oblastí (ML/AI, statistika, programování atd.) a tam, kde to dává smysl, uveďte úroveň znalostí. U seniorních pozic zdůrazněte vedle konkrétních technologií pokročilé techniky modelování a architektonická rozhodnutí. Uveďte klasické statistické metody i moderní přístupy ML, abyste ukázali pevné teoretické základy spojené s praxí. Cílem je ucelený, ale zaměřený obraz vašich technických schopností, vždy s ohledem na požadavky konkrétní pozice. Uveďte odborné technické dovednosti i metodické přístupy, od konkrétních programovacích jazyků po návrh experimentů a postupy nasazování modelů.
Jak seřadit technické dovednosti
Rozdělte dovednosti do jasných kategorií, které jsou pro datovou vědu důležité:
Strojové učení/AI: deep learning, NLP, počítačové vidění, zpětnovazební učení, analýza časových řad
Statistika a matematika: statistické testování, návrh experimentů, bayesovské metody, lineární algebra
Programovací jazyky: Python (PyTorch, TensorFlow, scikit-learn), R (tidyverse, caret), SQL
Big data a cloud: Spark, Hadoop, AWS (SageMaker), GCP (Vertex AI), Azure ML
Vizualizace dat: Tableau, Power BI, Matplotlib, Seaborn, D3.js
MLOps a nástroje: Docker, Git, MLflow, Kubeflow, DVC, Weights & Biases
Pokročilé technické kompetence
U seniorních pozic uveďte pokročilé technické kompetence, které dokazují hluboké znalosti:
Strojové učení: návrh architektury modelů, transfer learning, few-shot learning, AutoML
MLOps: monitoring modelů, A/B testování, feature stores, registr modelů
Big data: distribuované výpočty, návrh datových pipeline, zpracování datových proudů
Výzkum: implementace odborných článků, návrh experimentů, rešerše literatury
Vývojové postupy: CI/CD pro ML, code review, dokumentace
Měkké dovednosti pro datové vědce
Uveďte netechnické dovednosti, které jsou pro datovou vědu zásadní:
Komunikace: vyprávění příběhů s daty, technické psaní, prezentace pro stakeholdery
Projektové řízení: Agile/Scrum, plánování sprintů, alokace zdrojů
Obchodní myšlení: analýza ROI, definice KPI, sběr požadavků
Vedení: mentorování týmu, spolupráce napříč odděleními, plánování projektů
Řešení problémů: testování hypotéz, analýza příčin, návrh řešení
Sekce pracovních zkušeností
Sekce pracovních zkušeností musí konkrétními a vyčíslenými úspěchy ukázat růst v technické náročnosti i přínosu pro byznys. Každá pozice by měla ukázat, že umíte proměnit poznatky z dat v hodnotu pro firmu, a zároveň předvést technické znalosti strojového učení a analytiky. Zaměřte se na odpovědnost za projekty od začátku do konce, od definice problému po nasazení a monitoring modelu. Uveďte objem zpracovávaných dat, metriky výkonu modelů a dosažený přínos pro byznys. Ukažte, že zvládáte celý životní cyklus strojového učení, od sběru a předzpracování dat po nasazení a údržbu modelu. U každé pozice uveďte nejen technologie, které jste použili, ale i proč jste je zvolili a jaké přinesly výsledky.
Ukázka zkušeností na seniorní pozici
U seniorních pozic zdůrazněte vedení, odpovědnost za projekty od začátku do konce a přínos pro byznys.
Senior Data Scientist | AI Solutions Inc. | 2020-dosud
Vedoucí datový vědec platformy pro analýzu zákazníků, která slouží klientům ze žebříčku Fortune 500
- Navrhl a nasadil doporučovací systém, který denně zpracuje přes 10 mil. interakcí uživatelů a zlepšil CTR o 45 %
- Vedl tým 5 datových vědců při vývoji modelu segmentace zákazníků, který zvýšil ROI marketingu o 85 %
- Zavedl automatizovanou ML pipeline, která zkrátila trénování modelu z 1 týdne na 6 hodin
- Vyvinul systém pro detekci anomálií v reálném čase s přesností 96 % v prevenci podvodů
- Zavedl postupy MLOps, které zkrátily nasazení modelů o 60 %
Technologie: Python, TensorFlow, AWS SageMaker, Spark, MLflow, Docker
Ukázka zkušeností na pozici se středními zkušenostmi
U pozic se středními zkušenostmi se zaměřte na realizaci projektů a rostoucí technický přínos.
Data Scientist | StartupTech | 2018-2020
Datový vědec pro platformu prediktivní analytiky
- Vytvořil a nasadil model pro predikci odchodu zákazníků s přesností 88 %
- Vyvinul NLP pipeline, která měsíčně zpracuje přes 100 tis. zákaznických recenzí
- Zavedl rámec pro A/B testování, který zrychlil experimenty o 300 %
- Vytvořil automatizovanou pipeline pro feature engineering, která zkrátila vývoj modelů o 50 %
- Ve spolupráci s vývojovým týmem nasadil do produkce 5 ML modelů
Klíčové dovednosti: Python, scikit-learn, NLP, A/B testování, feature engineering
Machine Learning Engineer | Tech Solutions | 2016-2018
ML inženýr pro doporučovací systémy
- Vytvořil doporučovací systém, který zvýšil zapojení uživatelů o 35 %
- Optimalizoval pipeline pro trénování modelů a snížil náklady o 40 %
- Zavedl API pro predikce v reálném čase, které zvládá přes 10 tis. požadavků za sekundu
- Vyvinul systém pro monitoring kvality dat, který snížil počet datových problémů o 70 %
Hlavní zaměření: doporučovací systémy, nasazování modelů, vývoj API
Projekty a technické úspěchy
Sekce projektů by měla ukázat, že umíte řešit složité problémy datové vědy a přinést měřitelný přínos pro byznys. Každý projekt by měl vyprávět celý příběh: řešený obchodní problém, zvolený technický přístup, rozhodnutí při modelování a vyčíslené výsledky. Zaměřte se na projekty, které ukazují znalosti v relevantních oblastech, jako je strojové učení, statistická analýza a datové inženýrství. Uveďte pracovní i osobní projekty, které ukazují iniciativu a technickou kreativitu. U každého projektu popište celý životní cyklus strojového učení, včetně přípravy dat, výběru modelu, strategie validace a nasazení. Tato sekce by měla ukázat nejen to, co jste vytvořili, ale i to, jak jste přistupovali ke složitým analytickým úkolům a co jste se naučili.
Jak popsat projekty
Každý projekt by měl jasně popsat vyřešený problém, použitou metodiku a vyčíslené výsledky.
Systém pro predikci odchodu zákazníků
Problém: vysoká míra odchodu zákazníků způsobovala ztrátu tržeb přes 2 mil. USD ročně
- Vyvinul ensemble ML model s přesností 88 % při predikci odchodu zákazníků
- Zavedl automatizovanou pipeline pro feature engineering, která zpracovává přes 50 metrik chování zákazníků
- Díky cíleným zásahům snížil odchod zákazníků o 35 %
- Nasadil model přes REST API, které zvládá přes 10 tis. predikcí denně
Technologie: Python, scikit-learn, XGBoost, FastAPI, PostgreSQL
Analýza tržního sentimentu v reálném čase
Problém: ruční zpracování dat o tržním sentimentu zdržovalo obchodní rozhodnutí
- Vytvořil NLP pipeline, která denně zpracuje přes 100 tis. finančních zpráv
- S modelem založeným na BERT dosáhl přesnosti 92 % při klasifikaci sentimentu
- Zkrátil zpoždění analýzy sentimentu z hodin na sekundy
- Zavedl streamovací architekturu pro tržní poznatky v reálném čase
Technologie: Python, PyTorch, Kafka, Elasticsearch, Docker
Úspěchy ve výzkumu a soutěžích
Zdůrazněte akademický výzkum a úspěchy v soutěžích z datové vědy.
Publikovaný výzkum: „Novel Approaches to Few-Shot Learning in Computer Vision“, citováno více než 100×
Soutěže na Kaggle: 2 zlaté medaile v soutěžích NLP, umístění v nejlepším 1 %
Přihlášený patent: „Efficient Method for Real-time Anomaly Detection in Time Series Data“
Open source: autor oblíbené knihovny pro augmentaci dat s více než 10 tis. hvězdičkami na GitHubu
Ocenění v oboru: Best Paper Award na ML Conference 2023
Vzdělání a technické certifikáty
Sekce vzdělání datového vědce by měla zdůraznit teoretické základy i praktické použití. Zaměřte se na relevantní předměty ze statistiky, strojového učení a informatiky. U vyšších titulů uveďte výzkum a publikace, které dokazují znalosti v konkrétních oblastech. Technické certifikáty vybírejte tak, aby ukázaly znalost standardních nástrojů a platforem v oboru. Uveďte nejen názvy certifikátů, ale i významné projekty nebo implementace, které jste díky těmto znalostem realizovali. Nezapomeňte zmínit akademické projekty s analýzou reálných dat, spoluprací s firmami nebo inovativním využitím strojového učení. Tato sekce by měla ukázat teoretické porozumění i schopnost použít pokročilé analytické postupy na praktické problémy.
Jak uvést vzdělání
Uveďte vzdělání s důrazem na relevantní předměty a výzkum.
Ph.D. v oboru strojové učení | Tech University | 2018-2022 • Disertační práce: „Advanced Techniques in Self-Supervised Learning for Computer Vision“ • 3 publikované články na předních ML konferencích (NeurIPS, ICML) • Zaměření výzkumu: deep learning, počítačové vidění, transfer learning • Hlavní projekty: - Vývoj nového algoritmu few-shot learning s výsledky na úrovni SOTA - Návrh účinných technik augmentace dat pro malé datové sady - Spolupráce s firmami na praktických aplikacích ML
Magisterský titul v oboru datová věda (Master of Science in Data Science) | State University | 2016-2018 • GPA (průměr známek): 3,95/4,0 • Relevantní předměty: pokročilé strojové učení, teorie statistického učení, deep learning • Diplomová práce: „Efektivní metody analýzy rozsáhlých časových řad“ • Ocenění: Outstanding Graduate Research Award, Data Science Fellowship
Profesní certifikáty
Uveďte certifikáty, které dokazují znalost relevantních technologií a metodik.
AWS Machine Learning Specialty Certification
Google Cloud Professional Data Engineer
TensorFlow Developer Certificate
Databricks Certified Machine Learning Professional
Deep Learning Specialization (deeplearning.ai)
Úprava a formátování životopisu
Životopis datového vědce musí vyvážit technickou hloubku a srozumitelnost a zároveň být čitelný pro ATS i pro lidi. K tomu potřebujete promyšlené formátování a klíčová slova typická pro datovou vědu. Používejte běžné názvy sekcí a přirozeně zařaďte relevantní pojmy ze strojového učení a statistiky. Rozvržení by mělo čtenáře provést vaším růstem v datové vědě a důležité informace by měly jít rychle přelétnout očima. Myslete na technické zázemí čtenářů: uveďte dost detailů, abyste ukázali odbornost, ale popisy držte srozumitelné i pro personalisty bez technického vzdělání. Dbejte na jednotné formátování, hlavně u odborných pojmů a metrik. Použijte čisté profesionální písmo a nechte dost volného místa, aby se text dobře četl. Přidejte odkazy na svůj profil na GitHubu, účet na Kaggle nebo publikace a ověřte, že fungují v digitální i tištěné verzi.
Úprava pro ATS u pozic v datové vědě
Zajistěte, aby životopis prošel systémem pro správu uchazečů (ATS) a zároveň se dobře četl.
Uveďte klíčové pojmy z ML/AI z popisu pozice (např. „strojové učení“, „deep learning“, „neuronové sítě“)
Používejte běžné názvy sekcí (Pracovní zkušenosti, Dovednosti, Vzdělání)
Zkratky alespoň jednou rozepište (např. „zpracování přirozeného jazyka (NLP)“)
Vyhněte se tabulkám a složitému formátování, které může systém ATS zmást
Uvádějte názvy nástrojů i pojmy (např. „PyTorch“, „konvoluční neuronové sítě“)
U certifikátů uveďte celý název i zkratku (např. „AWS Certified Solutions Architect - Associate (AWS-SAA)“)
Osvědčené postupy pro životopis v datové vědě
Naformátujte životopis tak, aby dobře ukázal vaše analytické a technické znalosti.
Začínejte výraznými čísly (přesnost, zlepšení výkonu, přínos pro byznys)
Přidejte odkazy na publikované články, repozitáře na GitHubu a profil na Kaggle
Seřaďte projekty podle typu (ML inženýrství, výzkum, analytika)
Zdůrazněte technické dovednosti i přínos pro byznys
Matematický zápis omezte na minimum a pište ho srozumitelně
Metriky výkonu modelů formátujte jednotně
Časté chyby v životopisech datových vědců
Vyhněte se těmto častým chybám v životopisech pro datovou vědu:
Vypisovat algoritmy bez ukázky praktického využití
Soustředit se na nástroje místo na způsob řešení problémů
Nevysvětlit přínos modelů pro byznys
Používat v profilu příliš mnoho odborného žargonu
Vynechat metriky výkonu modelů a strategie validace
Neukázat odpovědnost za projekty od začátku do konce


















Vaše zkušenosti nikdo nepřehlédne.
Vytvořte životopis čitelný pro ATS a přizpůsobený pozici, k němu sladěný motivační dopis a za pár minut se můžete ucházet o místo.
4,58/5
49 000+ uchazečů
Začněte zdarma · Platební karta není potřeba