Data Scientist: detaljeret guide til at skrive dit CV
Se dette CV-eksempel til en stilling som data scientist, og lav derefter en målrettet version med AI, eller tjek din CV-score.
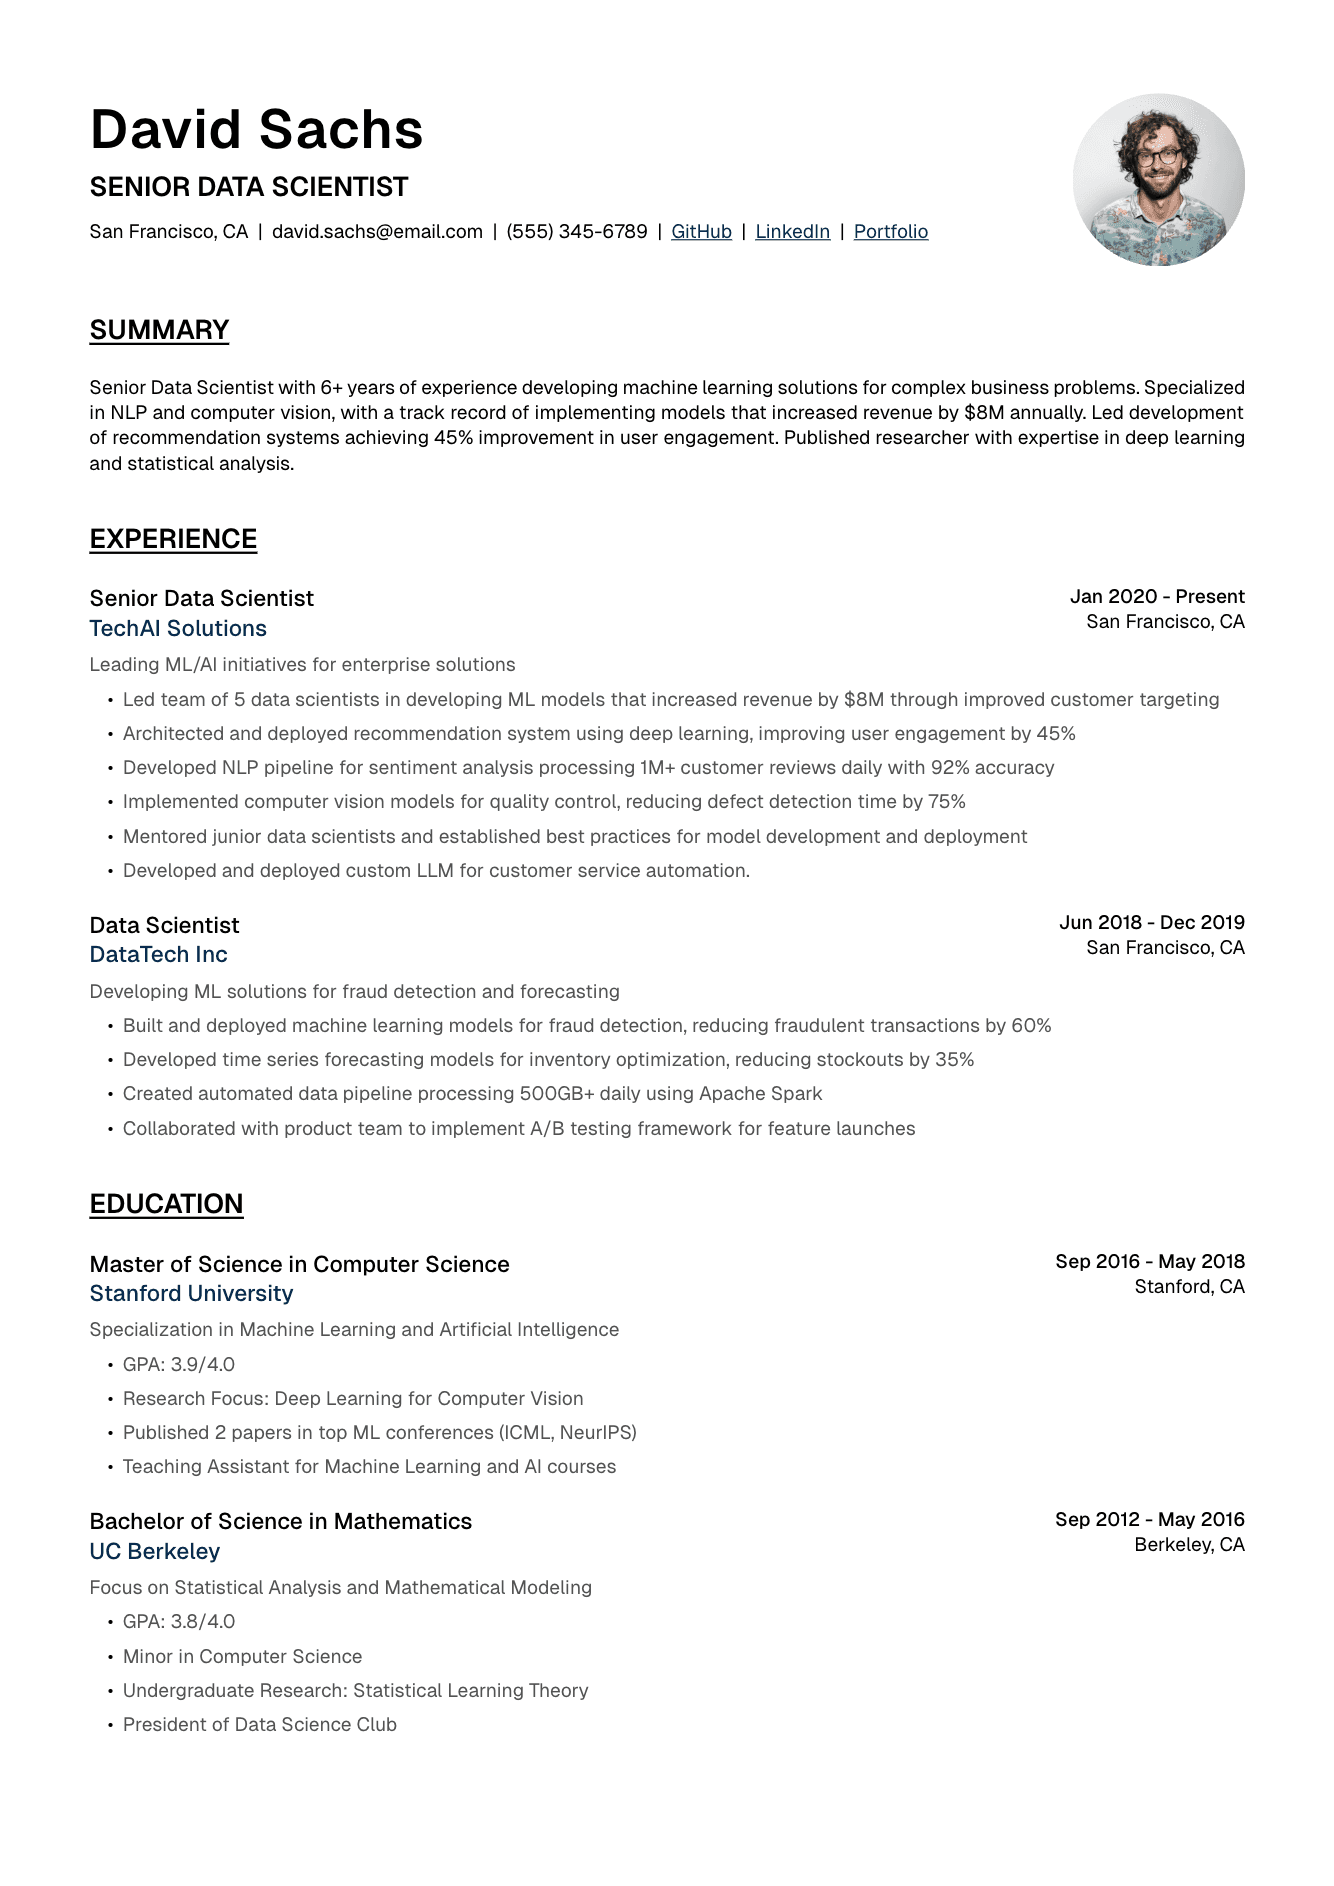
Profiltekst for data scientists
Som data scientist skal din profiltekst balancere teknisk ekspertise og forretningsforståelse og med det samme vise, at du kan omsætte komplekse data til brugbar indsigt. Sektionen skal fange opmærksomheden ved at vise dine vigtigste projekter, din ekspertise i modellering og den værdi, du har skabt for forretningen. Til seniorstillinger skal du lægge vægt på machine learning-systemer, du har sat i drift, og teams, du har ledet. Til stillinger på mellemniveau skal du fokusere på succesfulde modeller og analyser. Til juniorstillinger skal du fremhæve et solidt teoretisk fundament og praktiske projekter. Sæt konkrete tal på dine resultater, og hold teksten klar og slagkraftig. Tilpas sektionen til den konkrete stilling og branche, og fremhæv relevante domæner og tekniske specialer. Profilteksten skal ikke kun vise dine tekniske evner, men også hvordan dine analyser og modeller har ført til bedre beslutninger og forbedringer i forretningen.
Guide til profiltekst for senior data scientist
Til seniorstillinger skal din profiltekst lægge vægt på tre ting: teknisk ledelse inden for machine learning, ansvar for projekter fra start til slut og forretningsmæssig effekt. Fokuser på modeller i produktion, teams, du har ledet, og konkrete forbedringer.
Senior Data Scientist med 8+ års erfaring med at udvikle og sætte machine learning-løsninger i drift i stor skala. Har ledet udviklingen af en anbefalingsmotor, der skabte over 50 mio. USD i ekstra omsætning gennem højere brugerengagement. Ekspert i deep learning og NLP med dokumenteret erfaring med at mentorere teams og indføre MLOps-praksis, der forkortede tiden til idriftsættelse af modeller med 70 %.
Principal Data Scientist med speciale i computer vision og deep learning. 10+ års erfaring med at lede AI-initiativer i stor skala, herunder udvikling af et system til objektgenkendelse i realtid, der behandler over 1 mio. billeder dagligt med 98 % nøjagtighed. Ekspertise i PyTorch, TensorFlow og distribueret træning, der har sænket omkostningerne til modeltræning med 300.000 USD om året.
Start med din højeste titel og dine års erfaring
Nævn de ML-domæner og teknologier, du er særligt stærk i
Sæt tal på din effekt (øget omsætning, bedre nøjagtighed)
Fremhæv både produktresultater og ledelsesresultater
Hold den under 4 linjer, så den er let at læse
Guide til profiltekst for data scientist på mellemniveau
Data scientists på mellemniveau skal fokusere på succesfulde projekter og voksende teknisk ekspertise. Fremhæv dit ansvar for projekter fra start til slut og de konkrete tekniske udfordringer, du har løst.
Data Scientist med 4 års erfaring med at udvikle machine learning-løsninger til den finansielle sektor. Har designet og sat en model til opdagelse af svindel i drift, der behandler transaktioner for over 100 mio. USD dagligt med 99,5 % nøjagtighed. Har reduceret antallet af falske positiver med 40 % gennem nytænkende feature engineering og ensemble-modeller.
Machine Learning Engineer med 3 års erfaring med speciale i NLP og tekstanalyse. Har ledet udviklingen af en pipeline til sentimentanalyse, der behandler over 1 mio. kundeanmeldelser om måneden med 92 % nøjagtighed. Har gjort modeltræningen 5 gange mere effektiv med distribueret træning og automatisk udvælgelse af features.
Guide til profiltekst for junior data scientist
Til juniorstillinger skal du fokusere på din uddannelse, praktikophold og projekter. Læg vægt på dit solide teoretiske fundament og praktiske anvendelser.
Nyuddannet inden for data science med et solidt fundament i machine learning, statistik og softwareudvikling. Har gennemført 2 praktikophold i tech-virksomheder med udvikling og idriftsættelse af ML-modeller i Python, TensorFlow og AWS. Aktiv deltager i Kaggle-konkurrencer med 3 medaljer og har udgivet forskning inden for natural language processing.
Nyuddannet cand.scient. i data science med praktisk erfaring med machine learning fra flere forskningsprojekter og praktikophold. Har udviklet en model til forudsigelse af kundeafgang med 85 % nøjagtighed, der giver en forventet årlig besparelse på 200.000 USD. Behersker Python, R og SQL og lærer hurtigt nye teknologier.
Fremhæv relevante fag og forskningsprojekter
Læg vægt på praktikophold og konkrete bidrag
Vis resultater fra konkurrencer og egne projekter
Vis lyst til at lære hele tiden
Nævn de konkrete teknologier og ML-frameworks, du har brugt
Lav dit CV som data scientist efter dette eksempel
Brug eksemplet som udgangspunkt, og målret derefter indhold, nøgleord og layout til det jobopslag, du søger.
Tekniske kompetencer
Sektionen med tekniske kompetencer skal vise både bredde og dybde inden for machine learning, statistik og programmering og samtidig være ATS-venlig. Organiser kompetencerne efter område (ML/AI, statistik, programmering osv.), og angiv dit niveau, hvor det er relevant. Til seniorstillinger skal du fremhæve avancerede modelleringsteknikker og arkitekturvalg ved siden af de konkrete teknologier. Tag både klassiske statistiske metoder og nyeste ML-tilgange med for at vise et stærkt teoretisk fundament kombineret med praktisk ekspertise. Det vigtigste er at give et fyldestgørende, men fokuseret billede af dine tekniske evner, altid med kravene i de stillinger, du søger, for øje. Husk at tage både faglige kompetencer og metoder med, fra konkrete programmeringssprog til forsøgsdesign og idriftsættelse af modeller.
Sådan organiserer du dine tekniske kompetencer
Opdel dine kompetencer i klare kategorier, der er relevante for stillinger inden for data science:
Machine learning/AI: deep learning, NLP, computer vision, reinforcement learning, tidsserieanalyse
Statistik og matematik: statistiske test, forsøgsdesign, bayesianske metoder, lineær algebra
Programmeringssprog: Python (PyTorch, TensorFlow, scikit-learn), R (tidyverse, caret), SQL
Big data og cloud: Spark, Hadoop, AWS (SageMaker), GCP (Vertex AI), Azure ML
Datavisualisering: Tableau, Power BI, Matplotlib, Seaborn, D3.js
MLOps og værktøjer: Docker, Git, MLflow, Kubeflow, DVC, Weights & Biases
Avancerede tekniske kompetencer
Til seniorstillinger skal du tage tekniske kompetencer på højt niveau med, der viser dyb ekspertise:
Machine learning: design af modelarkitektur, transfer learning, few-shot learning, AutoML
MLOps: modelovervågning, A/B-test, feature stores, modelregister
Big data: distribueret databehandling, design af datapipelines, stream processing
Forskning: implementering af forskningsartikler, forsøgsdesign, litteraturgennemgang
Udviklingspraksis: CI/CD til ML, kodegennemgang, dokumentation
Personlige kompetencer for data scientists
Tag de vigtigste ikke-tekniske kompetencer med, der er afgørende i stillinger inden for data science:
Kommunikation: data storytelling, teknisk skrivning, præsentationer for interessenter
Projektledelse: Agile/Scrum, sprintplanlægning, ressourcefordeling
Forretningsforståelse: ROI-analyse, definition af KPI'er, kravindsamling
Ledelse: mentorering af teams, tværfagligt samarbejde, projektplanlægning
Problemløsning: hypotesetest, årsagsanalyse, løsningsdesign
Erhvervserfaring
Din erhvervserfaring skal vise en udvikling i teknisk kompleksitet og forretningsmæssig effekt gennem konkrete, målbare resultater. Hver stilling skal vise, at du kan omsætte indsigt fra data til forretningsværdi, og fremhæve din tekniske ekspertise inden for machine learning og analyse. Fokuser på ansvar for projekter fra start til slut, fra definition af problemet til idriftsættelse og overvågning af modellen. Tag detaljer med om datamængderne, modellernes performance og den opnåede forretningsmæssige effekt. Vis, at du kan arbejde i hele machine learning-livscyklussen, fra dataindsamling og forbehandling til idriftsættelse og vedligeholdelse af modeller. Fremhæv for hver stilling ikke kun, hvilke teknologier du brugte, men også hvorfor du valgte dem, og hvilke resultater de gav.
Eksempel på erfaring i en seniorstilling
Til seniorstillinger skal du lægge vægt på ledelse, ansvar for projekter fra start til slut og forretningsmæssig effekt.
Senior Data Scientist | AI Solutions Inc. | 2020-nu
Lead data scientist på en platform til kundeindsigt for Fortune 500-kunder
- Designede og satte et anbefalingssystem i drift, der behandler over 10 mio. brugerinteraktioner dagligt, og øgede CTR med 45 %
- Ledede et team på 5 data scientists i udviklingen af en model til kundesegmentering, der øgede marketing-ROI med 85 %
- Indførte en automatiseret ML-pipeline, der forkortede modeltræningen fra 1 uge til 6 timer
- Udviklede et system til anomalidetektion i realtid med 96 % nøjagtighed i forebyggelse af svindel
- Indførte MLOps-praksis, der forkortede tiden til idriftsættelse af modeller med 60 %
Teknologier: Python, TensorFlow, AWS SageMaker, Spark, MLflow, Docker
Eksempel på erfaring på mellemniveau
Til stillinger på mellemniveau skal du fokusere på gennemførelse af projekter og voksende teknisk effekt.
Data Scientist | StartupTech | 2018-2020
Data scientist på en platform til prædiktiv analyse
- Byggede og satte en model til forudsigelse af kundeafgang i drift med 88 % nøjagtighed
- Udviklede en NLP-pipeline, der behandler over 100.000 kundeanmeldelser om måneden
- Indførte et framework til A/B-test, der øgede tempoet i eksperimenter med 300 %
- Skabte en automatiseret pipeline til feature engineering, der forkortede udviklingstiden for modeller med 50 %
- Samarbejdede med udviklingsteamet om at sætte 5 ML-modeller i produktion
Kompetencer: Python, scikit-learn, NLP, A/B-test, feature engineering
Machine Learning Engineer | Tech Solutions | 2016-2018
ML-ingeniør på anbefalingssystemer
- Byggede en anbefalingsmotor, der øgede brugerengagementet med 35 %
- Optimerede pipelinen til modeltræning og sænkede omkostningerne med 40 %
- Indførte et API til forudsigelser i realtid, der håndterer over 10.000 forespørgsler i sekundet
- Udviklede et system til overvågning af datakvalitet, der reducerede dataproblemer med 70 %
Fokus: anbefalingssystemer, idriftsættelse af modeller, API-udvikling
Projekter og tekniske resultater
Din projektsektion skal vise, at du kan løse komplekse data science-problemer og levere målbar forretningsmæssig effekt. Hvert projekt skal fortælle en hel historie: det forretningsproblem, du løste, din tekniske tilgang, dine valg i modelleringen og de målbare resultater. Fokuser på projekter, der viser ekspertise inden for relevante områder som machine learning, statistisk analyse og data engineering. Tag både professionelle og egne projekter med, der viser initiativ og teknisk kreativitet. Beskriv for hvert projekt hele machine learning-livscyklussen, herunder dataforberedelse, valg af model, valideringsstrategi og overvejelser om idriftsættelse. Sektionen skal ikke kun vise, hvad du byggede, men også hvordan du greb komplekse analytiske udfordringer an, og hvilken indsigt du fik.
Sådan præsenterer du dine projekter
Hvert projekt skal tydeligt beskrive problemet, metoden og de målbare resultater.
System til forudsigelse af kundeafgang
Problem: Høj kundeafgang kostede over 2 mio. USD i tabt omsætning om året
- Udviklede en ensemble-model med 88 % nøjagtighed i forudsigelse af kundeafgang
- Indførte en automatiseret pipeline til feature engineering, der behandler 50+ nøgletal for kundeadfærd
- Reducerede kundeafgangen med 35 % gennem målrettede indsatser
- Satte modellen i drift via et REST API, der håndterer over 10.000 forudsigelser dagligt
Teknologier: Python, scikit-learn, XGBoost, FastAPI, PostgreSQL
Sentimentanalyse af markedet i realtid
Problem: Manuel behandling af markedsstemningen forsinkede handelsbeslutninger
- Byggede en NLP-pipeline, der behandler over 100.000 finansnyheder dagligt
- Opnåede 92 % nøjagtighed i sentimentklassificering med en BERT-baseret model
- Forkortede tiden for sentimentanalyse fra timer til sekunder
- Indførte en streamingarkitektur til markedsindsigt i realtid
Teknologier: Python, PyTorch, Kafka, Elasticsearch, Docker
Resultater fra forskning og konkurrencer
Fremhæv akademisk forskning og succes i data science-konkurrencer.
Udgivet forskning: ”Novel Approaches to Few-Shot Learning in Computer Vision”, citeret 100+ gange
Kaggle-konkurrencer: 2 guldmedaljer i NLP-konkurrencer, top 1 % på ranglisten
Patentanmeldt: ”Efficient Method for Real-time Anomaly Detection in Time Series Data”
Open source: Har skabt et populært bibliotek til data augmentation med over 10.000 stjerner på GitHub
Anerkendelse i branchen: Best Paper Award på ML Conference 2023
Uddannelse og tekniske certificeringer
Uddannelsessektionen for en data scientist skal lægge vægt på både det teoretiske fundament og praktisk anvendelse. Fokuser på relevante fag inden for statistik, machine learning og datalogi. Ved videregående uddannelser skal du fremhæve forskning og publikationer, der viser ekspertise inden for bestemte domæner. Vælg tekniske certificeringer, der viser, at du behersker branchens standardværktøjer og platforme. Nævn ikke kun certificeringernes navne, men også vigtige projekter eller implementeringer, som den viden har ført til. Husk at fremhæve studieprojekter med analyse af rigtige data, samarbejde med virksomheder eller nytænkende anvendelser af machine learning. Sektionen skal vise både din teoretiske forståelse og din evne til at anvende avancerede analytiske begreber på praktiske problemer.
Sådan præsenterer du din uddannelse
Præsenter din uddannelse med vægt på relevante fag og forskning.
Ph.d. i machine learning | Tech University | 2018-2022 • Afhandling: ”Advanced Techniques in Self-Supervised Learning for Computer Vision” • Har udgivet 3 artikler på førende ML-konferencer (NeurIPS, ICML) • Forskningsområder: deep learning, computer vision, transfer learning • Vigtigste projekter: - Udviklede en ny algoritme til few-shot learning med SOTA-resultater - Skabte effektive teknikker til data augmentation for små datasæt - Samarbejdede med virksomheder om ML-anvendelser i praksis
Cand.scient. i data science | State University | 2016-2018 • GPA: 3,95/4,0 • Relevante fag: avanceret machine learning, statistisk læringsteori, deep learning • Speciale: ”Efficient Methods for Large-Scale Time Series Analysis” • Priser: Outstanding Graduate Research Award, Data Science Fellowship
Faglige certificeringer
Nævn certificeringer, der viser ekspertise i relevante teknologier og metoder.
AWS Machine Learning Specialty-certificering
Google Cloud Professional Data Engineer
TensorFlow Developer Certificate
Databricks Certified Machine Learning Professional
Deep Learning Specialization, deeplearning.ai
Optimering og formatering af CV'et
Et CV som data scientist skal balancere teknisk dybde og klarhed og samtidig fungere både i ATS (rekrutteringssystem) og for menneskelige læsere. Det kræver en gennemtænkt formatering og nøgleord, der passer til stillinger inden for data science. Brug gængse overskrifter til sektionerne, og flet relevante begreber fra machine learning og statistik naturligt ind i hele CV'et. Layoutet skal føre læseren gennem din udvikling inden for data science, så de vigtigste oplysninger er lette at skimme. Tænk på læserens tekniske baggrund: tag nok detaljer med til at vise din ekspertise, men hold beskrivelserne forståelige for rekrutterere uden teknisk baggrund. Vær særligt opmærksom på ensartet formatering, især ved fagtermer og nøgletal. Brug en ren, professionel skrifttype, og hold god luft for at gøre CV'et lettere at læse. Husk at tage links med til din GitHub-profil, din Kaggle-konto eller dine publikationer, og sørg for, at de fungerer i både den digitale og den trykte version.
ATS-optimering til stillinger inden for data science
Sørg for, at dit CV kommer igennem ATS og samtidig er let at læse.
Brug vigtige ML- og AI-begreber fra jobopslaget (f.eks. ”machine learning”, ”deep learning”, ”neurale netværk”)
Brug gængse overskrifter til sektionerne (Erhvervserfaring, Kompetencer, Uddannelse)
Skriv forkortelser helt ud mindst én gang (f.eks. ”Natural Language Processing (NLP)”)
Undgå tabeller og kompliceret formatering, der kan forvirre ATS
Nævn både værktøjer og begreber (f.eks. ”PyTorch”, ”convolutional neural networks”)
Skriv certificeringer både fuldt ud og forkortet (f.eks. ”AWS Certified Solutions Architect - Associate (AWS-SAA)”)
Best practice for CV'er inden for data science
Formater dit CV, så det tydeligt viser din analytiske og tekniske ekspertise.
Start med slagkraftige nøgletal (nøjagtighed, forbedret performance, forretningsmæssig effekt)
Tag links med til publikationer, GitHub-repositories og Kaggle-profiler
Organiser projekterne efter type (ML engineering, forskning, analyse)
Fremhæv både tekniske kompetencer og forretningsmæssig effekt
Brug kun lidt matematisk notation, og hold den klar
Brug ensartet formatering til modellernes nøgletal
Typiske fejl i CV'er inden for data science
Undgå disse typiske fejl i CV'er inden for data science:
At nævne algoritmer uden at vise, hvordan de er brugt i praksis
At fokusere på værktøjer frem for tilgangen til at løse problemer
At undlade at forklare modellernes forretningsmæssige effekt
At bruge for meget teknisk jargon i profilteksten
At udelade modellernes nøgletal og valideringsstrategier
At undlade at vise ansvar for projekter fra start til slut


















Gør din erfaring umulig at overse.
Lav et ATS-venligt CV målrettet jobbet, skriv en ansøgning, der passer til CV'et, og vær klar til at søge på få minutter.
4,58/5
49.000+ jobsøgere
Start gratis · Intet kreditkort påkrævet