Data scientist : guide détaillé pour rédiger votre CV
Consultez cet exemple de CV data scientist, puis créez une version ciblée avec l'IA ou vérifiez le score de votre CV actuel.
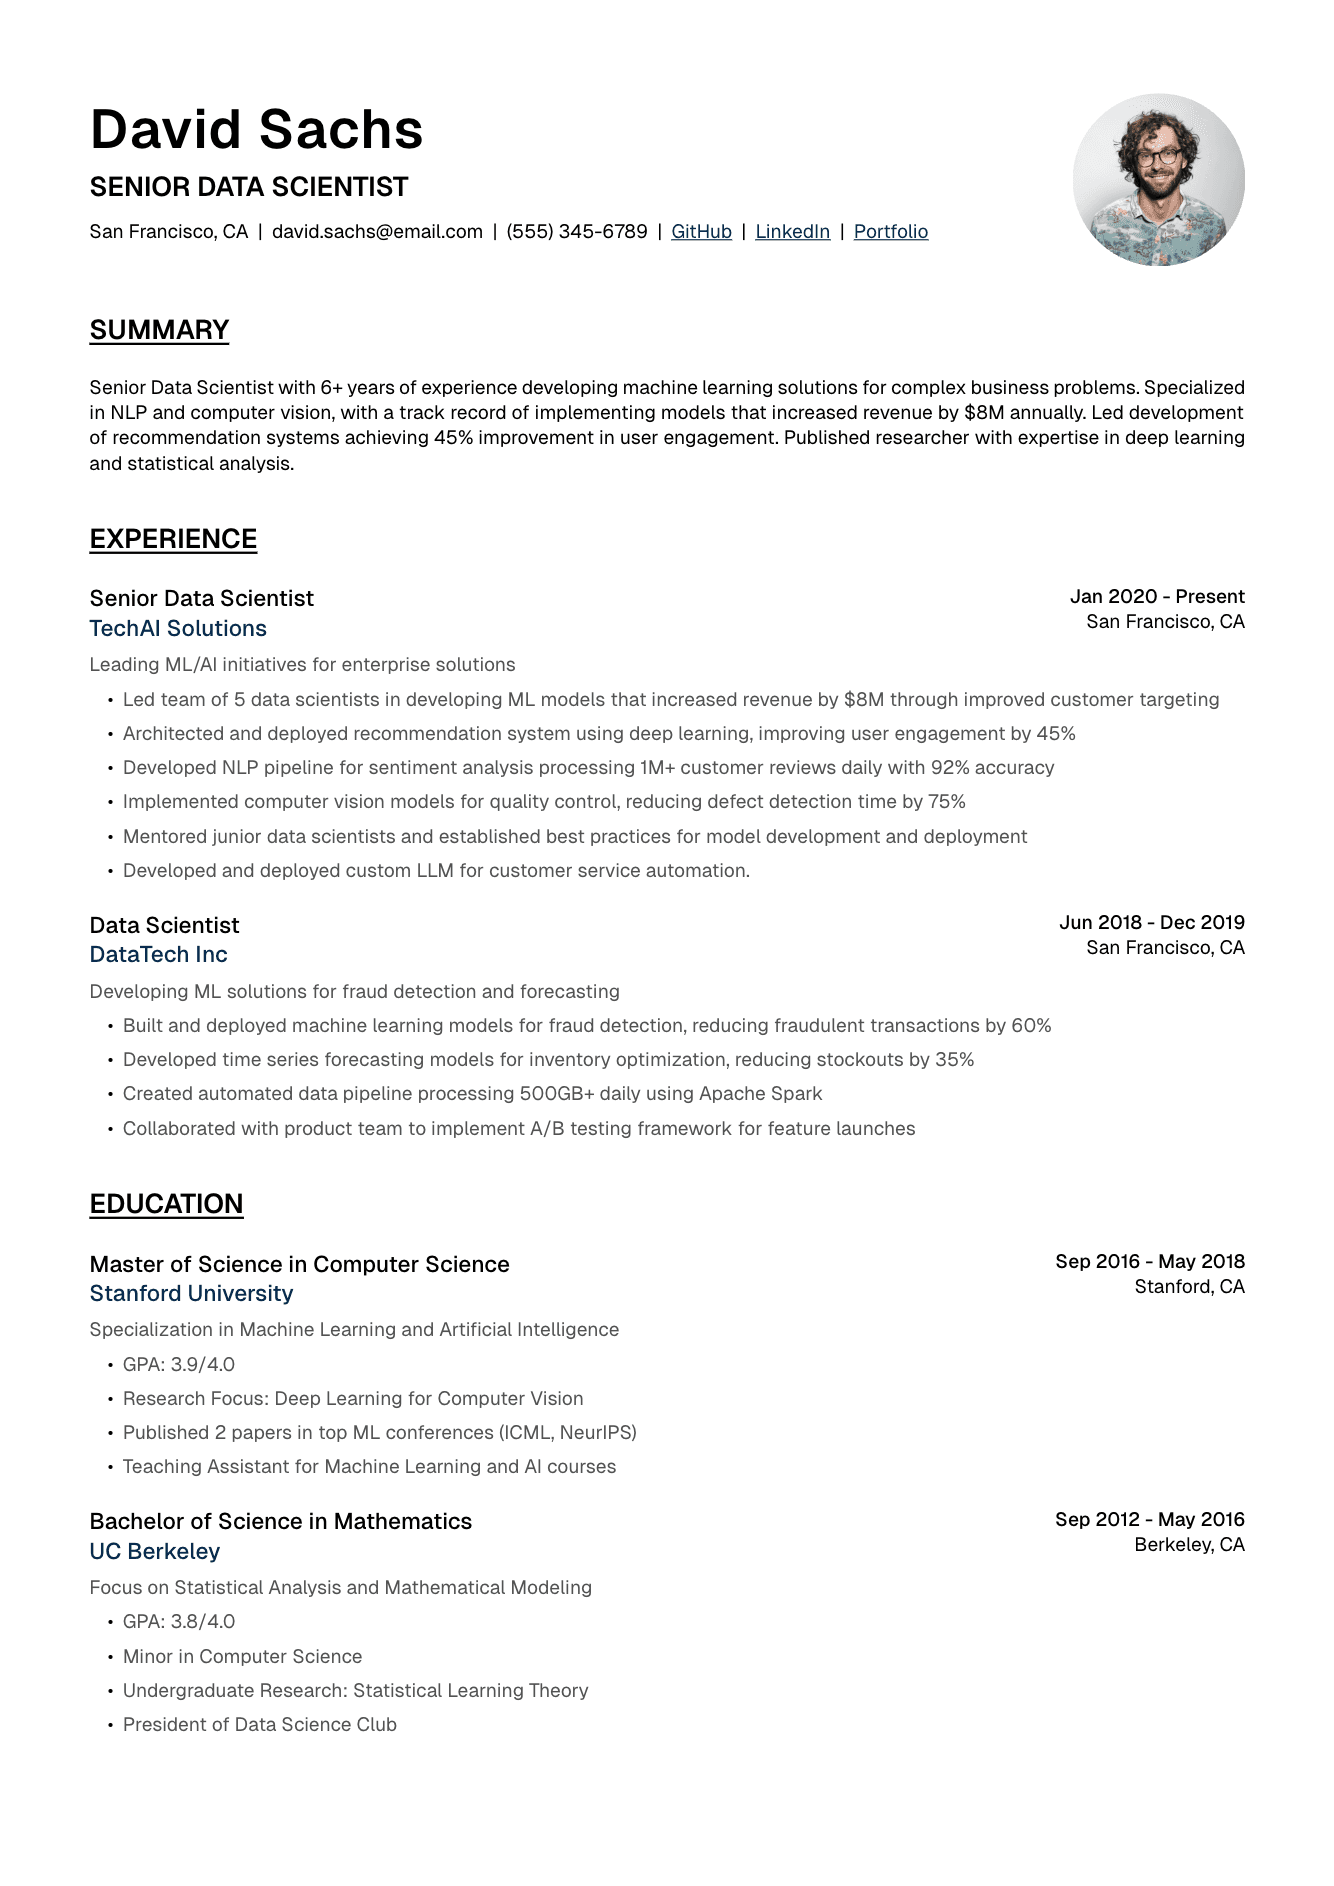
Résumé professionnel d'un data scientist
En tant que data scientist, votre résumé professionnel doit équilibrer expertise technique et sens des affaires, et montrer d'emblée que vous savez tirer des enseignements concrets de données complexes. Cette section doit retenir l'attention en présentant vos projets les plus marquants, votre expertise en modélisation et la valeur que vous avez créée pour l'entreprise. Pour un poste senior, mettez l'accent sur les systèmes de machine learning déployés et les équipes encadrées ; pour un poste intermédiaire, sur les modèles et analyses réussis ; pour un premier poste, sur de solides bases théoriques et des projets pratiques. Chiffrez vos réalisations avec des indicateurs précis tout en restant clair et percutant. Adaptez cette section au poste et au secteur, en mettant en avant vos domaines et spécialités techniques. Le résumé doit montrer non seulement vos compétences techniques, mais aussi comment vos analyses et vos modèles ont guidé les décisions et amélioré les résultats de l'entreprise.
Résumé professionnel d'un data scientist senior
Pour un poste senior, votre résumé doit mettre en avant trois éléments : le leadership technique en machine learning, la prise en charge des projets de bout en bout et l'impact sur l'activité. Insistez sur les modèles mis en production, les équipes encadrées et les améliorations concrètes obtenues.
Data scientist senior avec plus de 8 ans d'expérience dans le développement et le déploiement de solutions de machine learning à grande échelle. Pilotage du développement d'un moteur de recommandation ayant généré plus de 50 M$ de chiffre d'affaires supplémentaire grâce à un meilleur engagement des utilisateurs. Expert en deep learning et NLP, avec une solide expérience du mentorat d'équipes et de la mise en place de pratiques MLOps ayant réduit de 70 % le temps de déploiement des modèles.
Lead data scientist spécialisé en vision par ordinateur et deep learning. Plus de 10 ans d'expérience à la tête de projets d'IA à grande échelle, dont un système de détection d'objets en temps réel traitant plus de 1 million d'images par jour avec 98 % de précision. Expertise en PyTorch, TensorFlow et entraînement distribué, avec 300 000 $ d'économies annuelles sur les coûts d'entraînement des modèles.
Commencez par votre intitulé de poste le plus élevé et vos années d'expérience
Citez les domaines du ML et les technologies que vous maîtrisez le mieux
Chiffrez votre impact avec des indicateurs concrets (hausse du chiffre d'affaires, gain de précision)
Mettez en avant vos réussites produit comme managériales
Visez moins de 4 lignes pour rester lisible
Résumé professionnel d'un data scientist confirmé
Un data scientist confirmé doit mettre l'accent sur ses projets réussis et sur son expertise technique grandissante. Montrez que vous menez des projets de bout en bout et citez les défis techniques précis que vous avez relevés.
Data scientist avec 4 ans d'expérience dans le développement de solutions de machine learning pour les services financiers. Conception et déploiement d'un modèle de détection de fraude traitant plus de 100 M$ de transactions par jour avec 99,5 % de précision. Réduction de 40 % des faux positifs grâce à un feature engineering innovant et à des méthodes d'ensemble.
Ingénieur machine learning avec 3 ans d'expérience, spécialisé en NLP et en analyse de texte. Pilotage du développement d'un pipeline d'analyse de sentiment traitant plus de 1 million d'avis clients par mois avec 92 % de précision. Efficacité de l'entraînement des modèles multipliée par 5 grâce à l'entraînement distribué et à la sélection automatique des variables.
Résumé professionnel d'un data scientist débutant
Pour un premier poste, mettez l'accent sur votre formation, vos stages et vos projets. Insistez sur vos solides bases théoriques et leurs applications concrètes.
Jeune diplômé en data science avec de solides bases en machine learning, statistiques et génie logiciel. 2 stages réalisés dans des entreprises tech, avec le développement et le déploiement de modèles de ML en Python, TensorFlow et AWS. Participant actif aux compétitions Kaggle avec 3 médailles et des travaux de recherche publiés en traitement automatique du langage naturel.
Jeune diplômé d'un master en data science, avec une expérience pratique du machine learning acquise lors de plusieurs projets de recherche et stages. Développement d'un modèle de prédiction de l'attrition client atteignant 85 % de précision, pour une économie annuelle estimée à 200 000 $. Maîtrise de Python, R et SQL, avec une capacité prouvée à prendre en main rapidement de nouvelles technologies.
Mettez en avant les cours suivis et vos projets de recherche
Insistez sur vos stages et vos contributions concrètes
Montrez vos résultats en compétition et vos projets personnels
Prouvez votre envie d'apprendre en continu
Citez les technologies et frameworks de ML que vous avez utilisés
Créez votre CV data scientist à partir de cet exemple
Partez de cet exemple, puis adaptez le contenu, les mots-clés et la mise en page à l'offre d'emploi à laquelle vous postulez.
Compétences techniques
La section compétences techniques d'un data scientist doit montrer l'étendue et la profondeur de vos connaissances en machine learning, statistiques et programmation, tout en restant lisible par les logiciels de gestion des candidatures (ATS). Classez vos compétences par domaine (ML/IA, statistiques, programmation, etc.) et indiquez votre niveau quand c'est utile. Pour un poste senior, mettez en avant les techniques de modélisation avancées et vos choix d'architecture en plus des technologies. Citez à la fois des méthodes statistiques classiques et des approches de ML récentes pour montrer de solides bases théoriques alliées à une expertise pratique. L'objectif est de donner une image complète mais ciblée de vos compétences techniques, en tenant toujours compte des exigences des postes visés. Pensez à inclure à la fois les compétences techniques et les méthodes, des langages de programmation aux plans d'expérience et au déploiement des modèles.
Organiser vos compétences techniques
Classez vos compétences dans des catégories claires, adaptées aux métiers de la data science :
Machine learning/IA : deep learning, NLP, vision par ordinateur, apprentissage par renforcement, analyse de séries temporelles
Statistiques et mathématiques : tests statistiques, plans d'expérience, méthodes bayésiennes, algèbre linéaire
Langages de programmation : Python (PyTorch, TensorFlow, scikit-learn), R (tidyverse, caret), SQL
Big data et cloud : Spark, Hadoop, AWS (SageMaker), GCP (Vertex AI), Azure ML
Visualisation de données : Tableau, Power BI, Matplotlib, Seaborn, D3.js
MLOps et outils : Docker, Git, MLflow, Kubeflow, DVC, Weights & Biases
Compétences techniques avancées
Pour un poste senior, citez des compétences techniques de haut niveau qui prouvent une expertise approfondie :
Machine learning : conception d'architectures de modèles, transfer learning, few-shot learning, AutoML
MLOps : monitoring des modèles, tests A/B, feature stores, registre de modèles
Big data : calcul distribué, conception de pipelines de données, traitement de flux
Recherche : implémentation d'articles scientifiques, plans d'expérience, revue de littérature
Pratiques de développement : CI/CD pour le ML, revue de code, documentation
Soft skills du data scientist
Ajoutez les compétences non techniques indispensables en data science :
Communication : data storytelling, rédaction technique, présentations aux parties prenantes
Gestion de projet : Agile/Scrum, planification de sprints, allocation des ressources
Sens des affaires : analyse du ROI, définition des KPI, recueil des besoins
Leadership : mentorat d'équipe, collaboration transverse, planification de projets
Résolution de problèmes : tests d'hypothèses, analyse des causes racines, conception de solutions
Expérience professionnelle
Votre section expérience professionnelle doit montrer une progression en complexité technique et en impact sur l'activité, à travers des réalisations concrètes et chiffrées. Chaque poste doit prouver que vous savez transformer les données en valeur pour l'entreprise, tout en mettant en avant votre expertise en machine learning et en analyse de données. Insistez sur la prise en charge des projets de bout en bout, de la définition du problème au déploiement et au suivi des modèles. Précisez le volume de données traité, les performances des modèles et l'impact obtenu sur l'activité. Montrez que vous maîtrisez tout le cycle de vie du machine learning, de la collecte et du prétraitement des données au déploiement et à la maintenance des modèles. Pour chaque poste, indiquez non seulement les technologies utilisées, mais aussi pourquoi vous les avez choisies et quels résultats elles ont donnés.
Exemple d'expérience pour un poste senior
Pour un poste senior, mettez l'accent sur le leadership, la prise en charge des projets de bout en bout et l'impact sur l'activité.
Data scientist senior | AI Solutions Inc. | 2020 - aujourd'hui
Lead data scientist d'une plateforme d'analyse client utilisée par des clients du Fortune 500
- Conception et déploiement d'un système de recommandation traitant plus de 10 millions d'interactions utilisateurs par jour, avec un CTR en hausse de 45 %
- Direction d'une équipe de 5 data scientists pour développer un modèle de segmentation client ayant augmenté de 85 % le ROI marketing
- Mise en place d'un pipeline de ML automatisé ayant réduit le temps d'entraînement des modèles de 1 semaine à 6 heures
- Développement d'un système de détection d'anomalies en temps réel atteignant 96 % de précision dans la prévention de la fraude
- Mise en place de pratiques MLOps ayant réduit de 60 % le temps de déploiement des modèles
Technologies : Python, TensorFlow, AWS SageMaker, Spark, MLflow, Docker
Exemple d'expérience pour un poste intermédiaire
Pour un poste intermédiaire, mettez l'accent sur la réalisation des projets et votre impact technique grandissant.
Data scientist | StartupTech | 2018 - 2020
Data scientist sur une plateforme d'analyse prédictive
- Conception et déploiement d'un modèle de prédiction de l'attrition client atteignant 88 % de précision
- Développement d'un pipeline NLP traitant plus de 100 000 avis clients par mois
- Mise en place d'un framework de tests A/B ayant augmenté de 300 % le rythme des expérimentations
- Création d'un pipeline de feature engineering automatisé ayant réduit de 50 % le temps de développement des modèles
- Collaboration avec l'équipe d'ingénierie pour mettre en production 5 modèles de ML
Compétences clés : Python, scikit-learn, NLP, tests A/B, feature engineering
Ingénieur machine learning | Tech Solutions | 2016 - 2018
Ingénieur ML sur des systèmes de recommandation
- Développement d'un moteur de recommandation ayant augmenté l'engagement des utilisateurs de 35 %
- Optimisation du pipeline d'entraînement des modèles, avec 40 % de coûts en moins
- Mise en place d'une API de prédiction en temps réel traitant plus de 10 000 requêtes par seconde
- Développement d'un système de suivi de la qualité des données ayant réduit de 70 % les problèmes de données
Axes principaux : systèmes de recommandation, déploiement de modèles, développement d'API
Projets et réalisations techniques
Votre section projets doit montrer que vous savez résoudre des problèmes complexes de data science et obtenir un impact mesurable sur l'activité. Chaque projet doit raconter une histoire complète : le problème métier traité, l'approche technique choisie, les choix de modélisation et les résultats chiffrés. Choisissez des projets qui prouvent votre expertise dans les domaines utiles, comme le machine learning, l'analyse statistique et le data engineering. Incluez des projets professionnels et personnels qui montrent votre esprit d'initiative et votre créativité technique. Pour chaque projet, décrivez tout le cycle de vie du machine learning : préparation des données, choix du modèle, stratégie de validation et contraintes de déploiement. Cette section doit montrer non seulement ce que vous avez construit, mais aussi comment vous avez abordé des problèmes d'analyse complexes et ce que vous en avez appris.
Comment présenter un projet
Chaque projet doit présenter clairement le problème résolu, la méthode utilisée et les résultats chiffrés.
Système de prédiction de l'attrition client
Problème : un taux d'attrition élevé entraînant plus de 2 M$ de pertes de chiffre d'affaires par an
- Développement d'un modèle d'ensemble atteignant 88 % de précision dans la prédiction de l'attrition client
- Mise en place d'un pipeline de feature engineering automatisé traitant plus de 50 indicateurs de comportement client
- Réduction de 35 % de l'attrition client grâce à des actions ciblées
- Déploiement du modèle via une API REST traitant plus de 10 000 prédictions par jour
Technologies : Python, scikit-learn, XGBoost, FastAPI, PostgreSQL
Analyse du sentiment de marché en temps réel
Problème : un traitement manuel des données de sentiment de marché qui retardait les décisions de trading
- Création d'un pipeline NLP traitant plus de 100 000 articles d'actualité financière par jour
- 92 % de précision en classification de sentiment grâce à un modèle basé sur BERT
- Temps d'analyse du sentiment ramené de plusieurs heures à quelques secondes
- Mise en place d'une architecture de streaming pour des analyses de marché en temps réel
Technologies : Python, PyTorch, Kafka, Elasticsearch, Docker
Recherche et compétitions
Mettez en avant vos travaux de recherche et vos résultats en compétitions de data science.
Publication : « Novel Approaches to Few-Shot Learning in Computer Vision », citée plus de 100 fois
Compétitions Kaggle : 2 médailles d'or en NLP, classement dans le top 1 %
Demande de brevet déposée : « Méthode efficace de détection d'anomalies en temps réel dans des séries temporelles »
Open source : création d'une bibliothèque d'augmentation de données populaire (plus de 10 000 étoiles sur GitHub)
Distinction : Best Paper Award à la ML Conference 2023
Formation et certifications techniques
La section formation d'un data scientist doit valoriser à la fois les bases théoriques et les applications concrètes. Mettez en avant les cours utiles en statistiques, machine learning et informatique. Pour un diplôme de haut niveau, citez vos travaux de recherche et vos publications qui prouvent votre expertise dans un domaine précis. Choisissez vos certifications techniques pour montrer votre maîtrise des outils et plateformes de référence. Indiquez non seulement le nom de la certification, mais aussi les projets importants qui en ont découlé. Pensez à citer vos projets universitaires sur des données réelles, vos collaborations avec des partenaires industriels ou vos applications innovantes du machine learning. Cette section doit montrer à la fois votre compréhension théorique et votre capacité à appliquer des concepts d'analyse avancés à des problèmes concrets.
Présentation de la formation
Présentez votre formation en mettant l'accent sur les cours utiles et la recherche.
Doctorat (Ph.D.) en machine learning | Tech University | 2018 - 2022 • Thèse : « Advanced Techniques in Self-Supervised Learning for Computer Vision » • 3 articles publiés dans des conférences ML de premier plan (NeurIPS, ICML) • Axes de recherche : deep learning, vision par ordinateur, transfer learning • Projets clés : - Développement d'un nouvel algorithme de few-shot learning aux résultats état de l'art (SOTA) - Création de techniques efficaces d'augmentation de données pour les petits jeux de données - Collaboration avec des partenaires industriels sur des applications concrètes du ML
Master en data science | Université publique | 2016 - 2018 • Moyenne (GPA) : 3,95/4,0 • Cours pertinents : machine learning avancé, théorie de l'apprentissage statistique, deep learning • Mémoire : « Efficient Methods for Large-Scale Time Series Analysis » • Distinctions : Outstanding Graduate Research Award, Data Science Fellowship
Certifications professionnelles
Citez les certifications qui prouvent votre expertise des technologies et méthodes utiles au poste.
Certification AWS Machine Learning Specialty
Google Cloud Professional Data Engineer
TensorFlow Developer Certificate
Databricks Certified Machine Learning Professional
Deep Learning Specialization - deeplearning.ai
Optimisation et mise en forme du CV
Le CV d'un data scientist doit allier profondeur technique et clarté, tout en restant lisible par les ATS comme par les recruteurs. Cela demande une mise en forme réfléchie et des mots-clés propres aux métiers de la data science. Utilisez des titres de section standards et intégrez naturellement le vocabulaire du machine learning et des statistiques dans tout votre CV. La mise en page doit guider le lecteur dans votre parcours en data science, tout en laissant les informations essentielles faciles à parcourir. Pensez au profil technique de votre lecteur : donnez assez de détails pour prouver votre expertise, tout en restant compréhensible pour les recruteurs non techniques. Soignez la cohérence de la mise en forme, surtout pour les termes techniques et les chiffres. Choisissez une police sobre et professionnelle et laissez assez d'espace blanc pour faciliter la lecture. Pensez aussi à ajouter les liens vers votre profil GitHub, votre compte Kaggle ou vos publications, bien présentés pour la version numérique comme pour la version imprimée.
Optimiser votre CV de data scientist pour les ATS
Faites en sorte que votre CV passe les ATS tout en restant agréable à lire.
Reprenez les termes clés de ML/IA des offres d'emploi (par exemple « machine learning », « deep learning », « réseaux de neurones »)
Utilisez des titres de section standards (Expérience professionnelle, Compétences, Formation)
Écrivez les sigles en toutes lettres au moins une fois (par exemple « traitement automatique du langage naturel (NLP) »)
Évitez les tableaux et les mises en forme complexes qui peuvent perturber les ATS
Citez à la fois les outils et les concepts (par exemple « PyTorch », « réseaux de neurones convolutifs »)
Indiquez le nom complet et le sigle de vos certifications (par exemple « AWS Certified Solutions Architect - Associate (AWS-SAA) »)
Bonnes pratiques pour un CV de data scientist
Mettez en forme votre CV pour bien montrer votre expertise analytique et technique.
Commencez par des chiffres marquants (précision, gains de performance, impact sur l'activité)
Ajoutez les liens vers vos articles publiés, vos dépôts GitHub et votre profil Kaggle
Classez vos projets par type (ingénierie ML, recherche, analyse)
Mettez en avant vos compétences techniques comme votre impact sur l'activité
Limitez les notations mathématiques et gardez-les claires
Présentez les performances de vos modèles de façon homogène
Erreurs fréquentes sur un CV de data scientist
Évitez ces erreurs fréquentes sur un CV de data scientist :
Lister des algorithmes sans montrer leurs applications concrètes
Mettre en avant les outils plutôt que votre façon de résoudre les problèmes
Oublier d'expliquer l'impact de vos modèles sur l'activité
Abuser du jargon technique dans le résumé professionnel
Omettre les performances des modèles et les stratégies de validation
Ne pas montrer que vous menez des projets de bout en bout


















Rendez votre expérience impossible à ignorer.
Créez un CV compatible ATS et adapté au poste, ajoutez une lettre de motivation assortie et soyez prêt à postuler en quelques minutes.
4,58/5
Plus de 49 000 candidats
Commencez gratuitement · Aucune carte bancaire requise