Data Scientist: grundig guide til hvordan du skriver CV-en
Se dette CV-eksempelet for en stilling som data scientist, og lag så en tilpasset versjon med KI eller sjekk CV-scoren din.
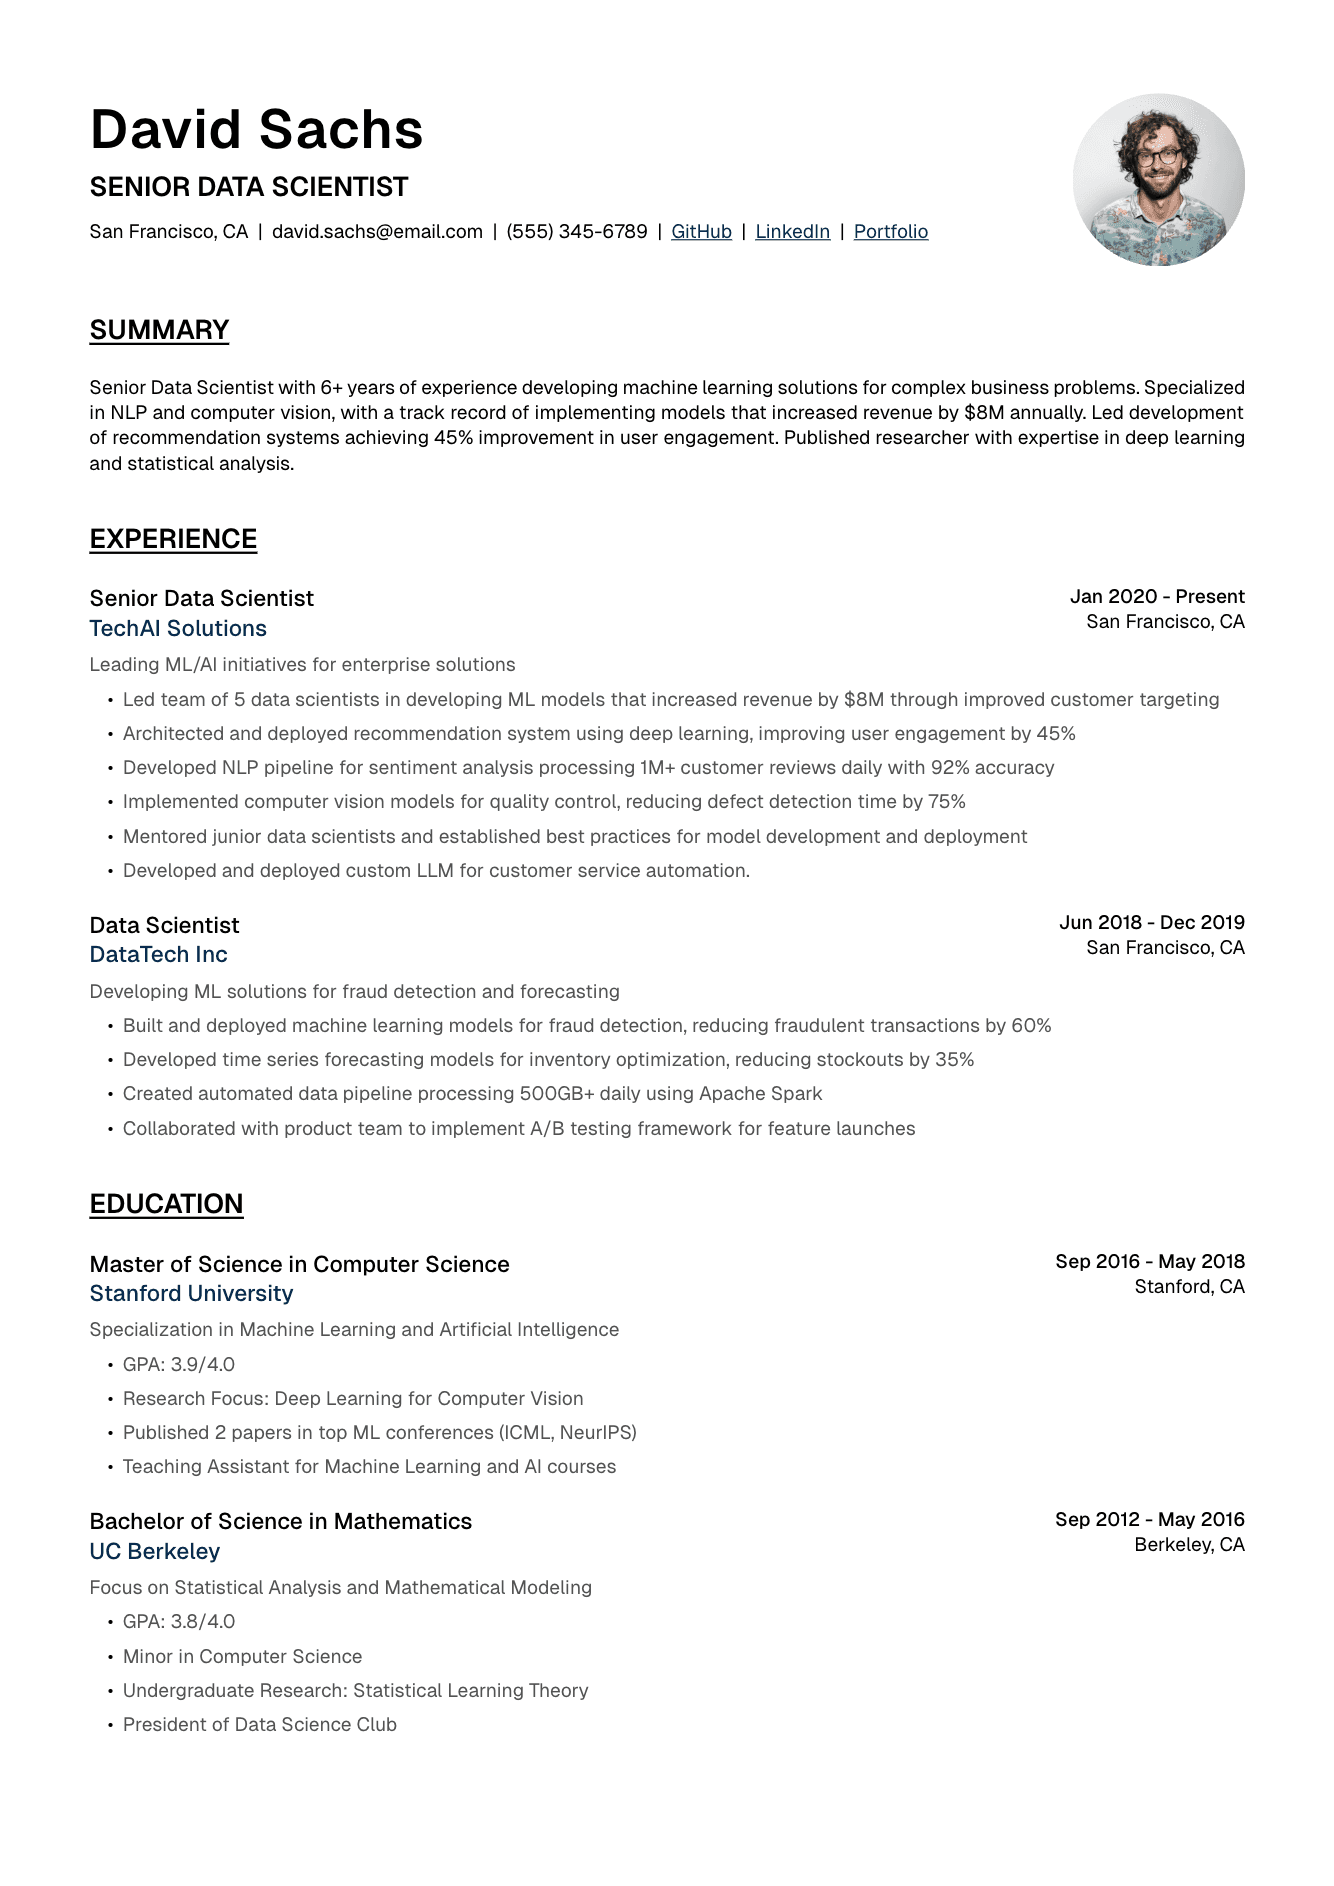
Sammendrag for data scientists
Sammendraget ditt som data scientist bør balansere teknisk kompetanse med forretningsforståelse og vise med en gang at du henter nyttig innsikt ut av komplekse data. Seksjonen må fange oppmerksomheten ved å løfte fram de viktigste prosjektene dine, kompetansen din i modellering og verdien du har skapt. For seniorroller bør du legge vekt på maskinlæringssystemer du har satt i produksjon og team du har ledet. For roller på mellomnivå bør du vise vellykkede modeller og analyser. For juniorroller bør du løfte fram et solid teoretisk grunnlag og praktiske prosjekter. Tallfest resultatene med konkrete tall, og hold teksten klar og slagkraftig. Tilpass seksjonen til rollen og bransjen, og løft fram relevante fagområder og tekniske spesialfelt. Sammendraget bør vise ikke bare hva du kan teknisk, men hvordan analysene og modellene dine har ført til bedre beslutninger og forbedringer.
Sammendrag for senior data scientist
For seniorroller bør sammendraget legge vekt på tre ting: teknisk ledelse innen maskinlæring, ansvar for prosjekter fra start til slutt og effekt på forretningen. Legg vekt på modeller i produksjon, team du har ledet og konkrete forbedringer.
Senior data scientist med over 8 års erfaring med å utvikle og sette maskinlæringsløsninger i produksjon i stor skala. Ledet utviklingen av en anbefalingsmotor som ga over 50 mill. USD i økte inntekter gjennom høyere brukerengasjement. Ekspert på dyp læring og NLP, med dokumentert erfaring med å veilede team og innføre MLOps-praksis som kortet ned tiden til produksjon med 70 %.
Principal data scientist med spesialisering i datasyn og dyp læring. Over 10 års erfaring med å lede KI-satsinger i stor skala, blant annet utvikling av et system for objektgjenkjenning i sanntid som behandler over 1 million bilder daglig med 98 % nøyaktighet. Kompetanse i PyTorch, TensorFlow og distribuert trening, som har redusert kostnadene til modelltrening med 300 000 USD i året.
Start med din høyeste stillingstittel og antall års erfaring
Nevn ML-områdene og teknologiene du er sterkest på
Tallfest effekten med konkrete tall (inntektsøkning, bedre nøyaktighet)
Vis både produktresultater og lederresultater
Hold det under 4 linjer, så er det lett å lese
Sammendrag for data scientist på mellomnivå
På mellomnivå bør du legge vekt på vellykkede prosjekter og voksende teknisk kompetanse. Vis at du har hatt ansvar for prosjekter fra start til slutt, og hvilke tekniske utfordringer du har løst.
Data scientist med 4 års erfaring med maskinlæringsløsninger for finansbransjen. Utformet og satte i produksjon en modell for svindeloppdagelse som behandler transaksjoner for over 100 mill. USD daglig med 99,5 % nøyaktighet. Reduserte antallet falske positiver med 40 % gjennom nyskapende feature engineering og ensemblemodeller.
ML-ingeniør med 3 års erfaring med NLP og tekstanalyse. Ledet utviklingen av en pipeline for sentimentanalyse som behandler over 1 million kundeanmeldelser i måneden med 92 % nøyaktighet. Gjorde modelltreningen 5 ganger mer effektiv ved å innføre distribuert trening og automatisk utvalg av variabler.
Sammendrag for juniorstilling som data scientist
Søker du en juniorstilling, bør du legge vekt på utdanning, praksisplasser og prosjekter. Vis at du har et solid teoretisk grunnlag og kan bruke det i praksis.
Nyutdannet innen datavitenskap med solid grunnlag i maskinlæring, statistikk og programvareutvikling. Har hatt 2 praksisplasser i teknologiselskaper, med utvikling og produksjonssetting av ML-modeller i Python, TensorFlow og AWS. Aktiv i Kaggle-konkurranser med 3 medaljer og publisert forskning innen naturlig språkbehandling.
Nyutdannet master i datavitenskap med praktisk erfaring i maskinlæring fra flere forskningsprosjekter og praksisplasser. Utviklet en modell for å forutsi kundefrafall med 85 % nøyaktighet, med en forventet årlig besparelse på 200 000 USD. Behersker Python, R og SQL og lærer nye teknologier raskt.
Løft fram relevante fag og forskningsprosjekter
Legg vekt på praksisplasser og konkrete bidrag
Vis resultater fra konkurranser og egne prosjekter
Vis at du liker å lære nye ting
Nevn teknologiene og ML-rammeverkene du har brukt
Skriv CV-en din som data scientist etter dette eksempelet
Bruk eksempelet som utgangspunkt, og tilpass innhold, nøkkelord og oppsett til stillingsannonsen du søker på.
Tekniske ferdigheter
Seksjonen for tekniske ferdigheter må vise både bredde og dybde innen maskinlæring, statistikk og programmering, og samtidig være ATS-vennlig. Ordne ferdighetene etter område (ML/KI, statistikk, programmering osv.) og oppgi nivå der det er relevant. For seniorstillinger bør du legge vekt på avanserte modelleringsteknikker og arkitekturvalg i tillegg til konkrete teknologier. Ta med både tradisjonelle statistiske metoder og nye ML-metoder for å vise et solid teoretisk grunnlag kombinert med praktisk kompetanse. Målet er å gi et helhetlig, men fokusert bilde av hva du kan teknisk, alltid med kravene i stillingen du søker på i tankene. Husk å ta med både tekniske ferdigheter og metoder, fra konkrete programmeringsspråk til forsøksdesign og produksjonssetting av modeller.
Slik ordner du tekniske ferdigheter
Ordne ferdighetene i tydelige kategorier som passer for stillinger innen datavitenskap:
Maskinlæring/KI: dyp læring, NLP, datasyn, forsterkende læring, tidsserieanalyse
Statistikk og matematikk: statistisk testing, forsøksdesign, bayesianske metoder, lineær algebra
Programmeringsspråk: Python (PyTorch, TensorFlow, scikit-learn), R (tidyverse, caret), SQL
Stordata og sky: Spark, Hadoop, AWS (SageMaker), GCP (Vertex AI), Azure ML
Datavisualisering: Tableau, Power BI, Matplotlib, Seaborn, D3.js
MLOps og verktøy: Docker, Git, MLflow, Kubeflow, DVC, Weights & Biases
Avansert teknisk kompetanse
For seniorroller bør du ta med teknisk kompetanse på høyt nivå som viser dyp ekspertise:
Maskinlæring: design av modellarkitektur, transfer learning, few-shot learning, AutoML
MLOps: modellovervåking, A/B-testing, feature stores, modellregister
Stordata: distribuert databehandling, design av datapipelines, strømprosessering
Forskning: implementering av forskningsartikler, forsøksdesign, litteraturgjennomgang
Utviklingspraksis: CI/CD for ML, kodegjennomgang, dokumentasjon
Personlige egenskaper for data scientists
Ta med viktige ikke-tekniske ferdigheter som betyr mye i datavitenskap:
Kommunikasjon: historiefortelling med data, teknisk skriving, presentasjoner for interessenter
Prosjektledelse: Agile/Scrum, sprintplanlegging, ressursfordeling
Forretningsforståelse: ROI-analyse, definering av KPI-er, kravinnhenting
Ledelse: veiledning av teammedlemmer, tverrfaglig samarbeid, prosjektplanlegging
Problemløsning: hypotesetesting, rotårsaksanalyse, løsningsdesign
Arbeidserfaring
Arbeidserfaringen din må vise at du har tatt på deg mer teknisk krevende oppgaver og hatt større effekt på forretningen, med konkrete og målbare resultater. Hver rolle bør vise at du gjør innsikt fra data om til verdi for forretningen, og løfte fram den tekniske kompetansen din i maskinlæring og analyse. Legg vekt på ansvar for prosjekter fra start til slutt, fra problemdefinisjon til produksjonssetting og overvåking av modeller. Ta med hvor store datamengder du har jobbet med, tall for modellytelse og effekten på forretningen. Vis at du behersker hele livsløpet i maskinlæring, fra datainnsamling og forbehandling til produksjonssetting og vedlikehold av modeller. For hver stilling bør du vise ikke bare hvilke teknologier du brukte, men hvorfor du valgte dem og hvilke resultater de ga.
Eksempel på arbeidserfaring: seniorrolle
For seniorstillinger bør du legge vekt på ledelse, ansvar for prosjekter fra start til slutt og effekt på forretningen.
Senior data scientist | AI Solutions Inc. | 2020–nå
Ledende data scientist for en plattform for kundeinnsikt som betjener Fortune 500-kunder
- Utformet og satte i produksjon et anbefalingssystem som behandler over 10 millioner brukerinteraksjoner daglig og økte klikkraten (CTR) med 45 %
- Ledet et team på 5 data scientists i utviklingen av en modell for kundesegmentering som økte ROI på markedsføringen med 85 %
- Innførte en automatisert ML-pipeline som kortet ned modelltreningen fra 1 uke til 6 timer
- Utviklet et system for avviksdeteksjon i sanntid med 96 % nøyaktighet i svindelforebygging
- Innførte MLOps-praksis som kortet ned tiden til produksjon for modeller med 60 %
Teknologier: Python, TensorFlow, AWS SageMaker, Spark, MLflow, Docker
Eksempel på arbeidserfaring: mellomnivå
For stillinger på mellomnivå bør du legge vekt på gjennomføring av prosjekter og voksende teknisk effekt.
Data scientist | StartupTech | 2018–2020
Data scientist for en plattform for prediktiv analyse
- Bygget og satte i produksjon en modell for å forutsi kundefrafall med 88 % nøyaktighet
- Utviklet en NLP-pipeline som behandler over 100 000 kundeanmeldelser i måneden
- Innførte et rammeverk for A/B-testing som økte tempoet i eksperimenteringen med 300 %
- Laget en automatisert pipeline for feature engineering som halverte utviklingstiden for modeller
- Samarbeidet med utviklingsteamet om å sette 5 ML-modeller i produksjon
Viktigste ferdigheter: Python, scikit-learn, NLP, A/B-testing, feature engineering
ML-ingeniør | Tech Solutions | 2016–2018
ML-ingeniør for anbefalingssystemer
- Bygget en anbefalingsmotor som økte brukerengasjementet med 35 %
- Optimaliserte pipelinen for modelltrening og reduserte kostnadene med 40 %
- Innførte et API for prediksjoner i sanntid som håndterer over 10 000 forespørsler i sekundet
- Utviklet et system for overvåking av datakvalitet som reduserte datafeil med 70 %
Hovedfokus: anbefalingssystemer, produksjonssetting av modeller, API-utvikling
Prosjekter og tekniske resultater
Prosjektseksjonen bør vise at du løser komplekse problemer i datavitenskap og leverer målbar effekt for forretningen. Hvert prosjekt bør fortelle en hel historie: forretningsproblemet, den tekniske fremgangsmåten, valgene du tok i modelleringen og de målbare resultatene. Velg prosjekter som viser kompetanse på relevante områder som maskinlæring, statistisk analyse og datateknikk. Ta med både jobbprosjekter og egne prosjekter som viser initiativ og teknisk kreativitet. Beskriv hele livsløpet i maskinlæring for hvert prosjekt, med dataklargjøring, modellvalg, valideringsstrategi og hensyn ved produksjonssetting. Seksjonen bør vise ikke bare hva du bygget, men hvordan du løste komplekse analytiske utfordringer og hva du lærte.
Slik presenterer du prosjekter
Hvert prosjekt bør vise tydelig problemet du løste, metoden du brukte og de målbare resultatene.
System for å forutsi kundefrafall
Problem: Høyt kundefrafall som ga over 2 mill. USD i tapte inntekter i året
- Utviklet en ensemble-modell med 88 % nøyaktighet i å forutsi kundefrafall
- Innførte en automatisert pipeline for feature engineering som behandler over 50 mål på kundeatferd
- Reduserte kundefrafallet med 35 % gjennom målrettede tiltak
- Satte modellen i produksjon via et REST API som håndterer over 10 000 prediksjoner daglig
Teknologier: Python, scikit-learn, XGBoost, FastAPI, PostgreSQL
Sentimentanalyse av markedet i sanntid
Problem: Manuell behandling av data om markedsstemning ga forsinkede handelsbeslutninger
- Bygget en NLP-pipeline som behandler over 100 000 finansnyheter daglig
- Oppnådde 92 % nøyaktighet i sentimentklassifisering med en BERT-basert modell
- Kortet ned tiden for sentimentanalyse fra timer til sekunder
- Innførte en strømmearkitektur for markedsinnsikt i sanntid
Teknologier: Python, PyTorch, Kafka, Elasticsearch, Docker
Forskning og konkurranseresultater
Løft fram akademisk forskning og gode resultater i konkurranser innen datavitenskap.
Publisert forskning: «Novel Approaches to Few-Shot Learning in Computer Vision», sitert over 100 ganger
Kaggle-konkurranser: 2 gullmedaljer i NLP-konkurranser, blant de 1 % beste
Patentsøknad: «Efficient Method for Real-time Anomaly Detection in Time Series Data»
Åpen kildekode: Laget et populært bibliotek for dataaugmentering med over 10 000 stjerner på GitHub
Anerkjennelse i bransjen: Best Paper Award på ML Conference 2023
Utdanning og tekniske sertifiseringer
Utdanningsseksjonen for en data scientist bør vise både teoretisk grunnlag og praktisk bruk. Legg vekt på relevante fag innen statistikk, maskinlæring og informatikk. Har du en høyere grad, bør du løfte fram forskning og publikasjoner som viser kompetanse på bestemte fagområder. Velg tekniske sertifiseringer som viser at du behersker standardverktøy og plattformer i bransjen. Ta ikke bare med navnet på sertifiseringen, men også viktige prosjekter eller løsninger som kom ut av kunnskapen. Husk å løfte fram studieprosjekter med analyse av ekte data, samarbeid med næringslivet eller nyskapende bruk av maskinlæring. Seksjonen bør vise både teoretisk forståelse og evne til å bruke avanserte analytiske metoder på praktiske problemer.
Slik presenterer du utdanningen
Presenter utdanningen med vekt på relevante fag og forskning.
Ph.d. i maskinlæring | Tech University | 2018–2022 • Avhandling: «Advanced Techniques in Self-Supervised Learning for Computer Vision» • Publiserte 3 artikler på ledende ML-konferanser (NeurIPS, ICML) • Forskningsområder: dyp læring, datasyn, transfer learning • Viktige prosjekter: - Utviklet en ny algoritme for few-shot learning med SOTA-resultater - Utviklet effektive teknikker for dataaugmentering for små datasett - Samarbeidet med partnere i næringslivet om ML-løsninger i praksis
Master i datavitenskap | State University | 2016–2018 • Karaktersnitt (GPA): 3,95/4,0 • Relevante fag: avansert maskinlæring, statistisk læringsteori, dyp læring • Masteroppgave: «Efficient Methods for Large-Scale Time Series Analysis» • Priser: Outstanding Graduate Research Award, Data Science Fellowship
Faglige sertifiseringer
List opp sertifiseringer som viser kompetanse i relevante teknologier og metoder.
AWS Certified Machine Learning – Specialty
Google Cloud Professional Data Engineer
TensorFlow Developer Certificate
Databricks Certified Machine Learning Professional
Deep Learning Specialization (deeplearning.ai)
Optimalisering og formatering av CV-en
CV-en til en data scientist må balansere teknisk dybde med klarhet, og den må fungere både i ATS (rekrutteringssystemer) og for menneskelige lesere. Det krever gjennomtenkt formatering og nøkkelord som passer for stillinger innen datavitenskap. Bruk vanlige seksjonsoverskrifter og ta med relevante begreper fra maskinlæring og statistikk på en naturlig måte gjennom hele CV-en. Oppsettet bør lede leseren gjennom utviklingen din i datavitenskap, samtidig som den viktigste informasjonen er lett å skumlese. Tenk på hvor teknisk leseren er: ta med nok detaljer til å vise kompetansen din, men hold beskrivelsene forståelige for rekrutterere uten teknisk bakgrunn. Vær nøye med lik formatering, særlig for fagbegreper og tall. Bruk en ren, profesjonell skrifttype og nok luft for å gjøre teksten lett å lese. Husk lenker til GitHub-profilen din, Kaggle-kontoen eller publikasjonene dine, og sørg for at de fungerer både digitalt og på papir.
ATS-optimalisering for stillinger i datavitenskap
Sørg for at CV-en kommer gjennom ATS og samtidig er lett å lese.
Ta med viktige ML/KI-begreper fra stillingsannonsen (f.eks. «maskinlæring», «dyp læring», «nevrale nettverk»)
Bruk vanlige seksjonsoverskrifter (Arbeidserfaring, Ferdigheter, Utdanning)
Skriv forkortelser fullt ut minst én gang (f.eks. «naturlig språkbehandling (NLP)»)
Unngå tabeller og avansert formatering som kan forvirre ATS
Ta med både verktøynavn og begreper (f.eks. «PyTorch», «konvolusjonelle nevrale nettverk»)
Skriv sertifiseringer både fullt ut og forkortet (f.eks. «AWS Certified Solutions Architect – Associate (AWS-SAA)»)
Beste praksis for CV i datavitenskap
Formater CV-en slik at den viser den analytiske og tekniske kompetansen din.
Start med tall som viser effekt (nøyaktighet, forbedret ytelse, effekt på forretningen)
Ta med lenker til publiserte artikler, GitHub-repositorier og Kaggle-profiler
Ordne prosjektene etter type (ML-utvikling, forskning, analyse)
Vis både tekniske ferdigheter og effekt på forretningen
Bruk lite matematisk notasjon, og hold den tydelig
Bruk lik formatering for tall om modellytelse
Vanlige feil i CV-er for datavitenskap
Unngå disse vanlige feilene i CV-er for datavitenskap:
Å liste opp algoritmer uten å vise hvordan de er brukt i praksis
Å legge vekt på verktøy i stedet for hvordan du løser problemer
Å ikke forklare hvilken effekt modellene har hatt på forretningen
Å bruke for mye teknisk sjargong i sammendraget
Å utelate tall for modellytelse og valideringsstrategier
Å ikke vise ansvar for prosjekter fra start til slutt


















Gjør erfaringen din umulig å overse.
Lag en ATS-vennlig CV tilpasset stillingen, skriv et søknadsbrev som passer, og vær klar til å søke på få minutter.
4,58/5
49 000+ jobbsøkere
Start gratis · Krever ikke kredittkort