Data Scientist: utförlig guide till ett bra CV
Titta på det här CV-exemplet för en tjänst som data scientist och skapa sedan en anpassad version med AI eller kolla poängen på ditt nuvarande CV.
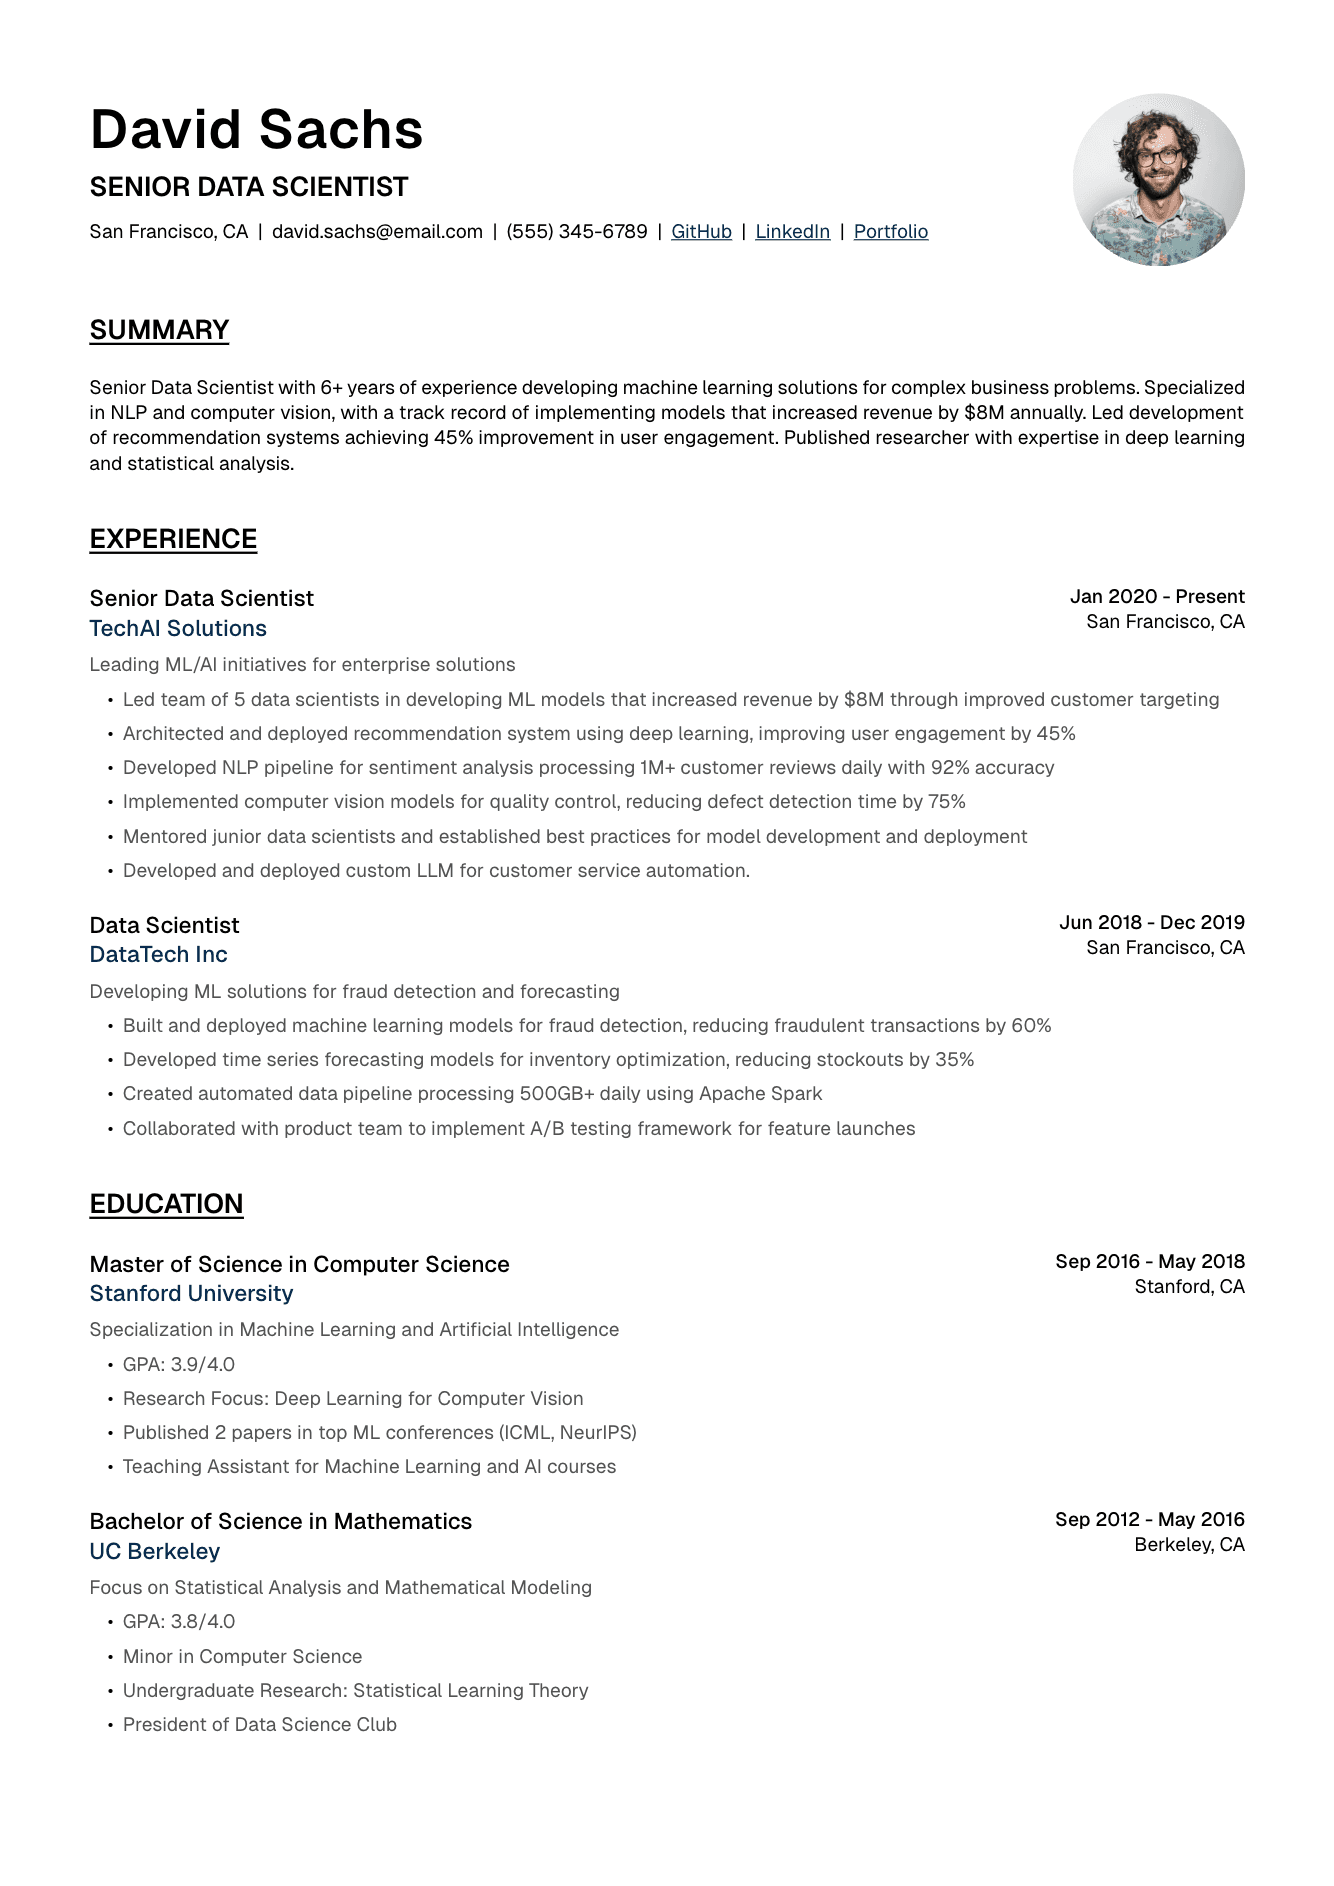
Profil för data scientists
Som data scientist ska din profil balansera teknisk expertis med affärssinne och direkt visa att du kan ta fram användbara insikter ur komplex data. Avsnittet måste fånga intresset genom att lyfta fram dina viktigaste projekt, din kunskap om modellering och den affärsnytta du bevisligen skapat. För seniora roller betonar du ML-system i drift och team du lett. För roller på mellannivå fokuserar du på lyckade modeller och analyser. För juniora roller lyfter du fram en stark teoretisk grund och praktiska projekt. Sätt konkreta siffror på resultaten och håll texten tydlig. Anpassa avsnittet efter roll och bransch och lyft fram relevanta områden och tekniska specialiteter. Profilen ska inte bara visa vad du kan tekniskt, utan också hur dina analyser och modeller har påverkat affärsbeslut och lett till förbättringar.
Profil för senior data scientist
För seniora roller ska profilen betona tre saker: tekniskt ledarskap inom maskininlärning, ansvar för projekt från början till slut och affärsnytta. Fokusera på modeller i produktion, team du lett och konkreta förbättringar.
Senior Data Scientist med över 8 års erfarenhet av att utveckla och driftsätta lösningar för maskininlärning i stor skala. Ledde utvecklingen av en rekommendationsmotor som gett över 50 MUSD i ytterligare intäkter genom ökat användarengagemang. Expert på deep learning och NLP, med dokumenterad erfarenhet av att coacha team och införa MLOps-arbetssätt som kortat tiden för driftsättning av modeller med 70 %.
Principal Data Scientist med inriktning på datorseende och deep learning. Över 10 års erfarenhet av att leda AI-satsningar i stor skala, bland annat utveckling av ett system för objektdetektering i realtid som bearbetar över 1 miljon bilder per dag med 98 % träffsäkerhet. Expert på PyTorch, TensorFlow och distribuerad träning, vilket sänkt kostnaderna för modellträning med 300 000 USD per år.
Börja med din mest seniora titel och antal år i yrket
Ange vilka ML-områden och tekniker du är särskilt stark inom
Sätt konkreta siffror på resultaten (ökade intäkter, bättre träffsäkerhet)
Lyft fram resultat både inom produkt och ledarskap
Håll den under 4 rader så att den blir lätt att läsa
Profil för data scientist på mellannivå
På mellannivå bör du fokusera på lyckade projekt och din växande tekniska kompetens. Lyft fram projekt du ansvarat för från början till slut och konkreta tekniska problem du löst.
Data Scientist med 4 års erfarenhet av att utveckla lösningar för maskininlärning inom finansbranschen. Designade och driftsatte en modell för bedrägeridetektering som hanterar transaktioner för över 100 MUSD per dag med 99,5 % träffsäkerhet. Minskade andelen falska larm med 40 % genom nytänkande feature engineering och ensemblemodeller.
Machine Learning Engineer med 3 års erfarenhet med inriktning på NLP och textanalys. Ledde utvecklingen av en pipeline för sentimentanalys som bearbetar över 1 miljon kundrecensioner per månad med 92 % träffsäkerhet. Gjorde modellträningen 5 gånger effektivare genom distribuerad träning och automatiskt urval av features.
Profil för junior data scientist
För juniora roller fokuserar du på utbildning, praktik och projekt. Betona din starka teoretiska grund och hur du tillämpat den i praktiken.
Nyexaminerad inom data science med stark grund i maskininlärning, statistik och mjukvaruutveckling. Har gjort 2 praktikperioder på techföretag och där utvecklat och driftsatt ML-modeller med Python, TensorFlow och AWS. Aktiv på Kaggle med 3 tävlingsmedaljer och publicerad forskning inom språkteknologi (NLP).
Nyexaminerad med masterexamen i data science och praktisk erfarenhet av maskininlärning från flera forskningsprojekt och praktikplatser. Utvecklade en modell för att förutsäga kundbortfall med 85 % träffsäkerhet, med beräknade årliga besparingar på 200 000 USD. Behärskar Python, R och SQL och lär mig snabbt nya tekniker.
Lyft fram relevanta kurser och forskningsprojekt
Betona praktikperioder och konkreta bidrag
Visa tävlingsresultat och egna projekt
Visa att du gärna lär dig nytt hela tiden
Ange vilka tekniker och ML-ramverk du använt
Skriv ditt CV som data scientist efter det här exemplet
Använd exemplet som utgångspunkt och anpassa sedan innehåll, nyckelord och layout efter annonsen för jobbet du söker.
Tekniska kompetenser
Avsnittet med tekniska kompetenser för en data scientist ska visa både bredd och djup inom maskininlärning, statistik och programmering, och samtidigt fungera i ATS. Ordna kompetenserna efter område (ML/AI, statistik, programmering och så vidare) och ange kunskapsnivå där det är relevant. För seniora roller betonar du avancerade modelleringstekniker och arkitekturbeslut vid sidan av konkreta tekniker. Ta med både klassiska statistiska metoder och moderna ML-metoder för att visa en stark teoretisk grund i kombination med praktisk erfarenhet. Det viktiga är att ge en heltäckande men fokuserad bild av din tekniska förmåga, alltid med kraven i tjänsten du söker i åtanke. Ta med både hårda tekniska kompetenser och metoder, från specifika programspråk till försöksdesign och driftsättning av modeller.
Så ordnar du tekniska kompetenser
Dela in dina kompetenser i tydliga kategorier som är relevanta för roller inom data science:
Maskininlärning/AI: deep learning, NLP, datorseende, förstärkningsinlärning, tidsserieanalys
Statistik och matematik: statistiska tester, försöksdesign, bayesianska metoder, linjär algebra
Programspråk: Python (PyTorch, TensorFlow, scikit-learn), R (tidyverse, caret), SQL
Big data och moln: Spark, Hadoop, AWS (SageMaker), GCP (Vertex AI), Azure ML
Datavisualisering: Tableau, Power BI, Matplotlib, Seaborn, D3.js
MLOps och verktyg: Docker, Git, MLflow, Kubeflow, DVC, Weights & Biases
Avancerade tekniska kompetenser
För seniora roller tar du med tekniska kompetenser på hög nivå som visar djup expertis:
Maskininlärning: design av modellarkitektur, transfer learning, few-shot learning, AutoML
MLOps: modellövervakning, A/B-tester, feature stores, modellregister
Big data: distribuerade beräkningar, design av datapipelines, strömmande databearbetning
Forskning: implementering av forskningsartiklar, försöksdesign, litteraturgenomgång
Utvecklingsarbete: CI/CD för ML, kodgranskning, dokumentation
Mjuka kompetenser för data scientists
Ta med de icke-tekniska kompetenser som är avgörande i roller inom data science:
Kommunikation: berättande med data, teknisk dokumentation, presentationer för intressenter
Projektledning: Agile/Scrum, sprintplanering, resursfördelning
Affärssinne: ROI-analys, definition av KPI:er, kravinsamling
Ledarskap: coachning av teammedlemmar, tvärfunktionellt samarbete, projektplanering
Problemlösning: hypotesprövning, rotorsaksanalys, lösningsdesign
Arbetslivserfarenhet
Avsnittet om arbetslivserfarenhet ska visa hur den tekniska komplexiteten och affärsnyttan har vuxit över tid, med konkreta och mätbara resultat. Varje roll ska visa att du kan omvandla insikter ur data till affärsvärde och samtidigt lyfta fram din tekniska kompetens inom maskininlärning och analys. Fokusera på projekt du ansvarat för från början till slut, från problemformulering till driftsättning och övervakning av modeller. Ta med uppgifter om hur stora datamängder du hanterat, modellernas prestanda och vilken affärsnytta du skapat. Visa att du kan arbeta genom hela livscykeln för maskininlärning, från datainsamling och förbehandling till driftsättning och underhåll av modeller. För varje tjänst lyfter du inte bara fram vilka tekniker du använde, utan också varför du valde dem och vilka resultat de gav.
Exempel på erfarenhet för seniora roller
För seniora roller betonar du ledarskap, ansvar för projekt från början till slut och affärsnytta.
Senior Data Scientist | AI Solutions Inc. | 2020–nu
Ledande data scientist för en plattform för kundinsikter med Fortune 500-kunder
- Designade och driftsatte ett rekommendationssystem som hanterar över 10 miljoner användarinteraktioner per dag och höjde CTR med 45 %
- Ledde ett team på 5 data scientists i utvecklingen av en modell för kundsegmentering som ökade marknadsföringens ROI med 85 %
- Införde en automatiserad ML-pipeline som kortade modellträningen från 1 vecka till 6 timmar
- Utvecklade ett system för avvikelsedetektering i realtid med 96 % träffsäkerhet i bedrägeriförebyggande arbete
- Införde MLOps-arbetssätt som kortade tiden för driftsättning av modeller med 60 %
Tekniker: Python, TensorFlow, AWS SageMaker, Spark, MLflow, Docker
Exempel på erfarenhet på mellannivå
För roller på mellannivå fokuserar du på hur du genomfört projekt och din växande tekniska påverkan.
Data Scientist | StartupTech | 2018–2020
Data scientist för en plattform för prediktiv analys
- Byggde och driftsatte en modell för att förutsäga kundbortfall med 88 % träffsäkerhet
- Utvecklade en NLP-pipeline som bearbetar över 100 000 kundrecensioner per månad
- Införde ett ramverk för A/B-tester som ökade takten i experimenten med 300 %
- Skapade en automatiserad pipeline för feature engineering som kortade utvecklingstiden för modeller med 50 %
- Samarbetade med utvecklingsteamet för att driftsätta 5 ML-modeller i produktion
Nyckelkompetenser: Python, scikit-learn, NLP, A/B-tester, feature engineering
Machine Learning Engineer | Tech Solutions | 2016–2018
ML-ingenjör för rekommendationssystem
- Byggde en rekommendationsmotor som ökade användarengagemanget med 35 %
- Optimerade pipelinen för modellträning och sänkte kostnaderna med 40 %
- Införde ett API för prediktioner i realtid som hanterar över 10 000 anrop per sekund
- Utvecklade ett system för övervakning av datakvalitet som minskade dataproblemen med 70 %
Fokus: rekommendationssystem, driftsättning av modeller, API-utveckling
Projekt och tekniska resultat
Projektavsnittet ska visa att du kan lösa komplexa problem inom data science och leverera mätbar affärsnytta. Varje projekt ska berätta hela historien: vilket affärsproblem du löste, vilken teknisk metod du valde, vilka beslut du fattade kring modellerna och vilka mätbara resultat du nådde. Fokusera på projekt som visar expertis inom relevanta områden som maskininlärning, statistisk analys och data engineering. Ta med både projekt från jobbet och egna projekt som visar initiativförmåga och teknisk kreativitet. Beskriv hela livscykeln för maskininlärning i varje projekt, inklusive dataförberedelse, val av modell, valideringsstrategi och överväganden kring driftsättning. Avsnittet ska inte bara visa vad du byggde, utan också hur du tog dig an komplexa analytiska utmaningar och vad du lärde dig.
Så presenterar du dina projekt
Varje projekt ska tydligt beskriva problemet du löste, metoden du använde och de mätbara resultaten.
System för att förutsäga kundbortfall
Problem: högt kundbortfall som orsakade intäktsförluster på över 2 MUSD per år
- Utvecklade en ensemblemodell som förutsäger kundbortfall med 88 % träffsäkerhet
- Införde en automatiserad pipeline för feature engineering som bearbetar över 50 mått på kundbeteende
- Minskade kundbortfallet med 35 % genom riktade åtgärder
- Driftsatte modellen via ett REST-API som hanterar över 10 000 prediktioner per dag
Tekniker: Python, scikit-learn, XGBoost, FastAPI, PostgreSQL
Sentimentanalys av marknaden i realtid
Problem: manuell bearbetning av marknadssentiment som fördröjde handelsbeslut
- Byggde en NLP-pipeline som bearbetar över 100 000 finansnyheter per dag
- Nådde 92 % träffsäkerhet i sentimentklassificering med en BERT-baserad modell
- Kortade sentimentanalysens fördröjning från timmar till sekunder
- Införde en strömmande arkitektur för marknadsinsikter i realtid
Tekniker: Python, PyTorch, Kafka, Elasticsearch, Docker
Forskning och tävlingsresultat
Lyft fram akademisk forskning och framgångar i tävlingar inom data science.
Publicerad forskning: ”Novel Approaches to Few-Shot Learning in Computer Vision”, citerad över 100 gånger
Kaggle-tävlingar: 2 guldmedaljer i NLP-tävlingar, bland de 1 % bästa
Patentansökan: ”Efficient Method for Real-time Anomaly Detection in Time Series Data”
Öppen källkod: skapade ett populärt bibliotek för dataaugmentering med över 10 000 stjärnor på GitHub
Utmärkelser: Best Paper Award vid ML Conference 2023
Utbildning och tekniska certifieringar
Utbildningsavsnittet för en data scientist ska lyfta fram både teoretisk grund och praktisk tillämpning. Fokusera på relevanta kurser inom statistik, maskininlärning och datavetenskap. Har du en högre examen, lyft fram forskning och publikationer som visar expertis inom specifika områden. Välj tekniska certifieringar som visar att du behärskar branschens standardverktyg och plattformar. Ta inte bara med namnen på certifieringarna utan också viktiga projekt eller implementeringar som kunskapen ledde till. Lyft också fram akademiska projekt med analys av verklig data, samarbeten med företag eller nyskapande tillämpningar av maskininlärning. Avsnittet ska visa både din teoretiska förståelse och din förmåga att tillämpa avancerade analytiska begrepp på praktiska problem.
Så presenterar du din utbildning
Presentera din utbildning med fokus på relevanta kurser och forskning.
Doktorsexamen i maskininlärning | Tech University | 2018–2022 • Avhandling: ”Advanced Techniques in Self-Supervised Learning for Computer Vision” • Publicerade 3 artiklar på ledande ML-konferenser (NeurIPS, ICML) • Forskningsområden: deep learning, datorseende, transfer learning • Viktiga projekt: - Utvecklade en ny algoritm för few-shot learning med SOTA-resultat - Tog fram effektiva tekniker för dataaugmentering för små dataset - Samarbetade med företag kring ML-tillämpningar i verkligheten
Masterexamen i data science | State University | 2016–2018 • GPA (snittbetyg): 3,95/4,0 • Relevanta kurser: avancerad maskininlärning, statistisk inlärningsteori, deep learning • Examensarbete: ”Efficient Methods for Large-Scale Time Series Analysis” • Utmärkelser: Outstanding Graduate Research Award, Data Science Fellowship
Yrkescertifieringar
Ange certifieringar som visar expertis inom relevanta tekniker och metoder.
AWS Machine Learning Specialty-certifiering
Google Cloud Professional Data Engineer
TensorFlow Developer Certificate
Databricks Certified Machine Learning Professional
Deep Learning Specialization, deeplearning.ai
Utformning och formatering av CV:t
Ett CV för data scientist ska balansera tekniskt djup med tydlighet och samtidigt fungera både i rekryteringssystem (ATS) och för mänskliga läsare. Det kräver genomtänkt formatering och nyckelord anpassade för roller inom data science. Använd vedertagna rubriker och väv in relevanta begrepp från maskininlärning och statistik på ett naturligt sätt i hela CV:t. Layouten ska leda läsaren genom din utveckling inom data science och samtidigt göra den viktigaste informationen lätt att skumma. Tänk på läsarens tekniska bakgrund: ta med tillräckligt med detaljer för att visa din expertis, men håll beskrivningarna begripliga för rekryterare utan teknisk bakgrund. Var noga med enhetlig formatering, särskilt för tekniska termer och mätetal. Använd ett rent, professionellt typsnitt och lagom med luft för att göra texten lättläst. Glöm inte länkar till din GitHub-profil, ditt Kaggle-konto eller dina publikationer, och se till att de fungerar både digitalt och i utskrift.
ATS-optimering för roller inom data science
Se till att ditt CV tar sig igenom rekryteringssystemen och samtidigt är lätt att läsa.
Ta med viktiga ML- och AI-begrepp från jobbannonsen (till exempel ”maskininlärning”, ”deep learning”, ”neurala nätverk”)
Använd vedertagna rubriker (Arbetslivserfarenhet, Kompetenser, Utbildning)
Skriv ut förkortningar minst en gång (till exempel ”Natural Language Processing (NLP)”)
Undvik tabeller och komplicerad formatering som kan förvirra ATS
Ta med både verktygsnamn och begrepp (till exempel ”PyTorch”, ”konvolutionella neurala nätverk”)
Ange certifieringar både fullt utskrivna och förkortade (till exempel ”AWS Certified Solutions Architect - Associate (AWS-SAA)”)
Bästa praxis för CV inom data science
Formatera ditt CV så att det tydligt visar din analytiska och tekniska kompetens.
Börja med slagkraftiga siffror (träffsäkerhet, prestandaförbättringar, affärsnytta)
Ta med länkar till publicerade artiklar, GitHub-repon och Kaggle-profiler
Ordna projekten efter typ (ML engineering, forskning, analys)
Lyft fram både tekniska kompetenser och affärsnytta
Håll matematisk notation till ett minimum och gör den tydlig
Använd enhetlig formatering för modellernas prestandamått
Vanliga misstag i CV för data science
Undvik de här vanliga fallgroparna i CV:n inom data science:
Att lista algoritmer utan att visa praktiska tillämpningar
Att fokusera på verktyg i stället för hur du löser problem
Att inte förklara modellernas affärsnytta
Att använda för mycket teknisk jargong i profiltexten
Att utelämna modellernas prestandamått och valideringsstrategier
Att inte visa att du ansvarat för projekt från början till slut


















Gör din erfarenhet omöjlig att missa.
Skapa ett ATS-vänligt CV anpassat efter jobbet, gör ett personligt brev som matchar och var redo att söka på några minuter.
4,58/5
49 000+ arbetssökande
Kom igång gratis · Inget betalkort krävs