Científico de datos: guía detallada para escribir tu CV
Revisa este ejemplo de CV de científico de datos y luego crea con IA una versión adaptada a la oferta o consulta la puntuación de tu CV actual.
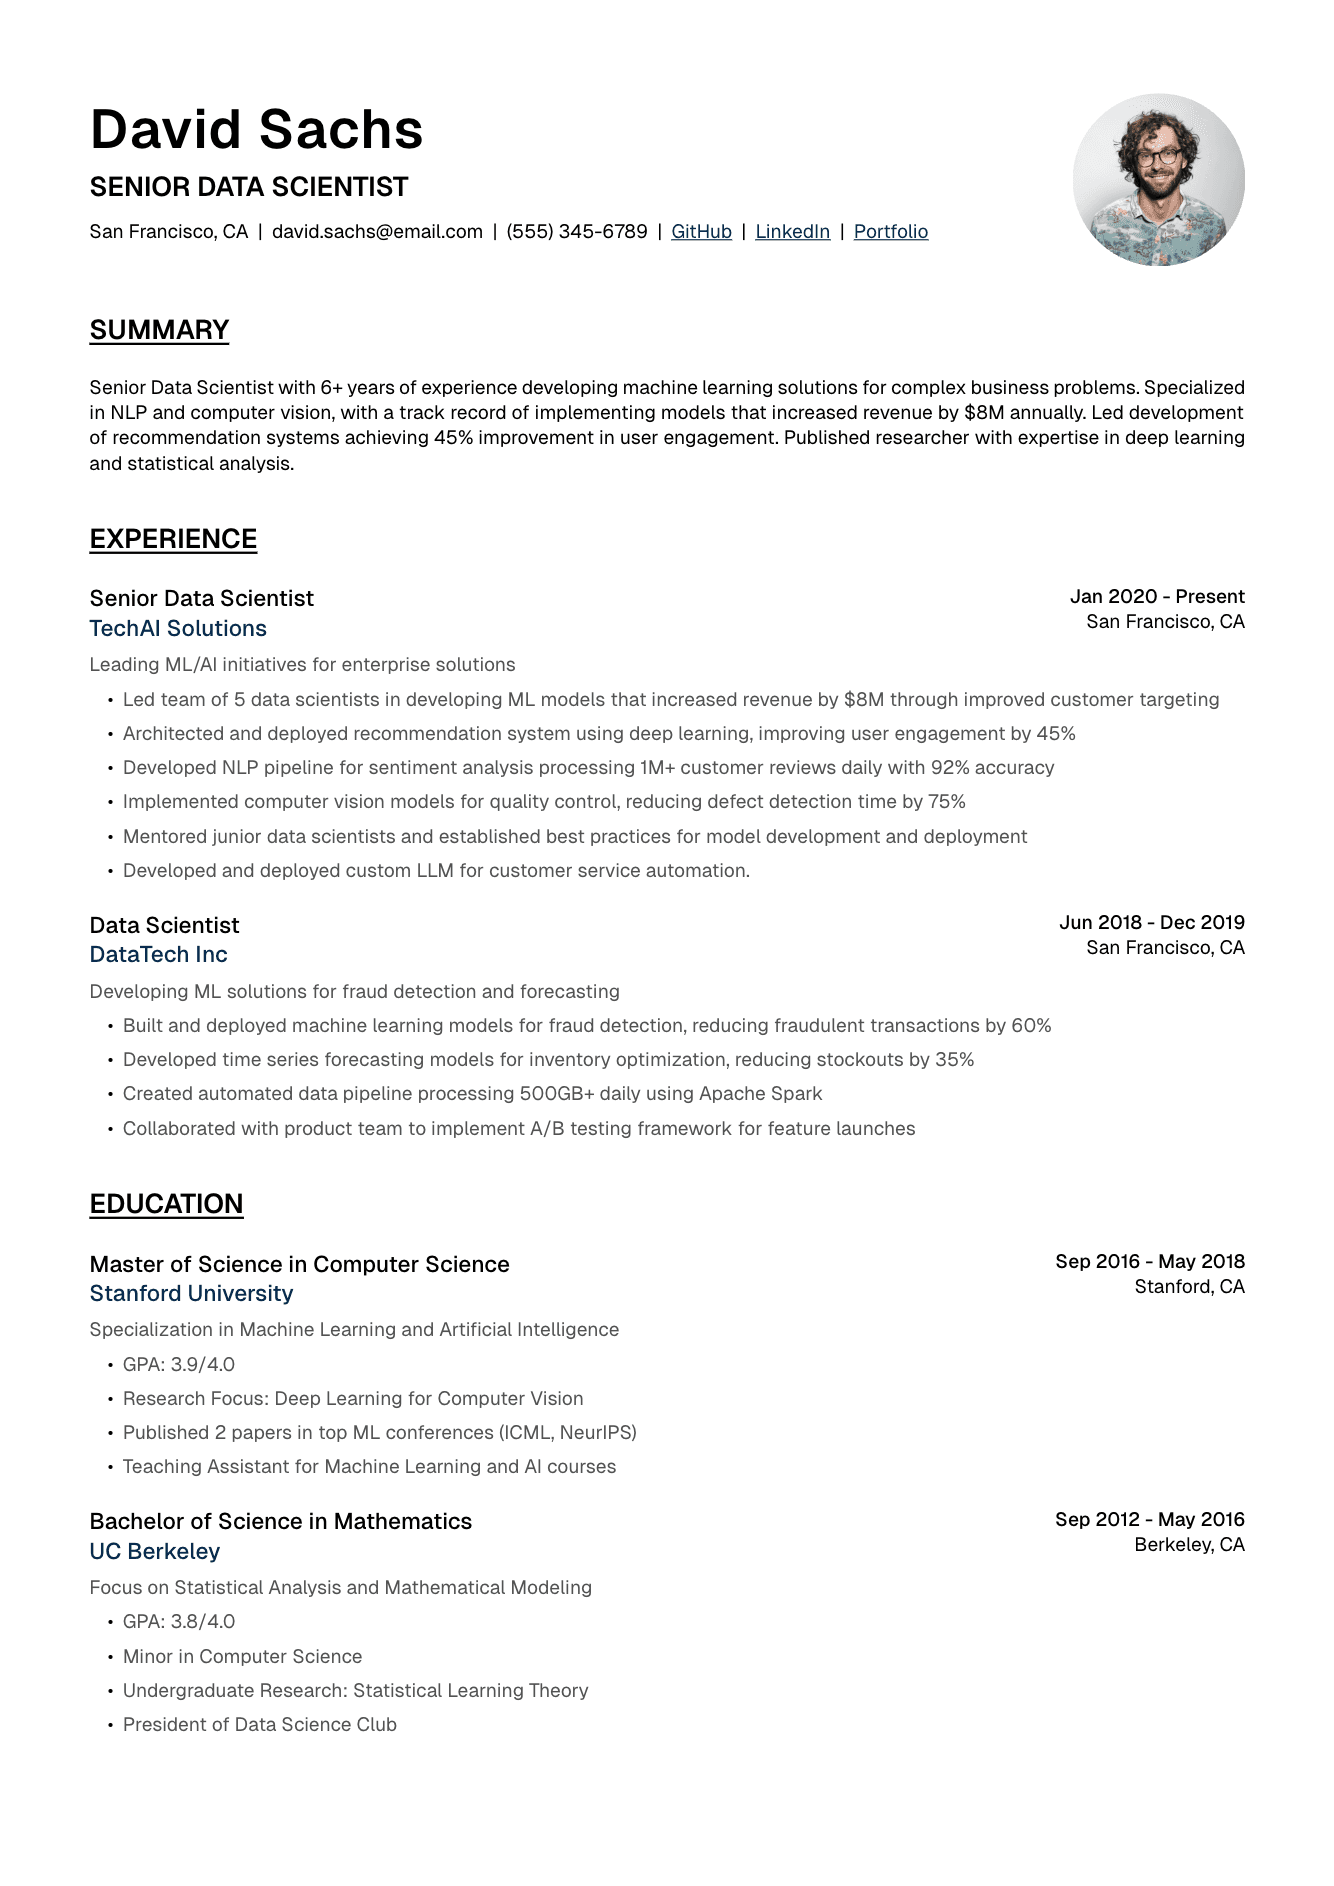
Resumen profesional para científicos de datos
Como científico de datos, tu resumen profesional debe equilibrar la experiencia técnica con la visión de negocio y mostrar desde el principio tu capacidad para sacar conclusiones útiles de datos complejos. Esta sección debe captar la atención con tus proyectos de mayor impacto, tu experiencia en modelado y el valor de negocio que has generado. Para puestos sénior, destaca los sistemas de machine learning que has puesto en producción y los equipos que has dirigido; para puestos intermedios, céntrate en modelos y análisis de éxito; para puestos de nivel inicial, destaca una base teórica sólida y proyectos prácticos. Cuantifica tus logros con métricas concretas, con claridad e impacto. Adapta esta sección al puesto y al sector, destacando los ámbitos y las especialidades técnicas relevantes. El resumen debe demostrar no solo tus capacidades técnicas, sino también cómo tus análisis y modelos han impulsado decisiones y mejoras en el negocio.
Guía del resumen para científicos de datos sénior
Para puestos sénior, tu resumen debe destacar tres elementos clave: liderazgo técnico en machine learning, responsabilidad de los proyectos de principio a fin e impacto en el negocio. Céntrate en los modelos puestos en producción, los equipos que has dirigido y las mejoras concretas que has logrado.
Científico de datos sénior con más de 8 años de experiencia desarrollando y desplegando soluciones de machine learning a gran escala. Dirigí el desarrollo de un motor de recomendaciones que generó más de $50 M en ingresos adicionales gracias a una mayor interacción de los usuarios. Experto en deep learning y NLP, con experiencia demostrada como mentor de equipos e implantando prácticas de MLOps que redujeron un 70% el tiempo de despliegue de modelos.
Científico de datos principal especializado en visión artificial y deep learning. Más de 10 años de experiencia liderando iniciativas de IA a gran escala, incluido el desarrollo de un sistema de detección de objetos en tiempo real que procesa más de 1 millón de imágenes al día con un 98% de precisión. Experto en PyTorch, TensorFlow y entrenamiento distribuido; reduje los costos de entrenamiento de modelos en $300.000 al año.
Empieza con tu puesto más alto y tus años de experiencia
Incluye los ámbitos de ML y las tecnologías concretas que dominas
Cuantifica tu impacto con métricas concretas (aumento de ingresos, mejoras de precisión)
Destaca logros tanto de producto como de liderazgo
Mantenlo en menos de 4 líneas para que se lea con facilidad
Guía del resumen para científicos de datos de nivel intermedio
Si tienes un nivel intermedio, céntrate en los proyectos de éxito y en tu creciente experiencia técnica. Destaca que llevas proyectos de principio a fin y los retos técnicos concretos que has resuelto.
Científico de datos con 4 años de experiencia desarrollando soluciones de machine learning para servicios financieros. Diseñé y desplegué un modelo de detección de fraude que procesa más de $100 M en transacciones diarias con un 99,5% de precisión. Reduje un 40% los falsos positivos con ingeniería de características innovadora y técnicas de modelos ensemble.
Ingeniero de machine learning con 3 años de experiencia, especializado en NLP y analítica de textos. Dirigí el desarrollo de un pipeline de análisis de sentimiento que procesa más de 1 millón de reseñas de clientes al mes con un 92% de precisión. Multipliqué por 5 la eficiencia del entrenamiento de modelos con entrenamiento distribuido y selección automática de características.
Guía del resumen para científicos de datos de nivel inicial
Para puestos de nivel inicial, céntrate en tu formación, tus prácticas y tus proyectos. Destaca tu sólida base teórica y sus aplicaciones prácticas.
Graduado en ciencia de datos con una sólida base en machine learning, estadística e ingeniería de software. Completé 2 periodos de prácticas en empresas tecnológicas, donde desarrollé y desplegué modelos de ML con Python, TensorFlow y AWS. Participante activo en competiciones de Kaggle, con 3 medallas, e investigación publicada en procesamiento del lenguaje natural.
Recién graduado de un máster en ciencia de datos con experiencia práctica en machine learning gracias a varios proyectos de investigación y prácticas. Desarrollé un modelo de predicción de abandono de clientes con un 85% de precisión, con un ahorro anual previsto de $200.000. Dominio de Python, R y SQL, y capacidad demostrada para aprender nuevas tecnologías con rapidez.
Destaca las asignaturas y los proyectos de investigación relevantes
Pon en valor tus prácticas y tus aportaciones concretas
Muestra tus logros en competiciones y tus proyectos personales
Demuestra tus ganas de seguir aprendiendo
Incluye las tecnologías y los frameworks de ML concretos que has usado
Crea tu CV de científico de datos siguiendo este ejemplo
Usa este ejemplo como punto de partida y luego adapta el contenido, las palabras clave y el diseño a la oferta de empleo a la que te postulas.
Sección de habilidades técnicas
La sección de habilidades técnicas de un científico de datos debe mostrar amplitud y profundidad en machine learning, estadística y programación, y a la vez ser compatible con los ATS. Organiza las habilidades por ámbito (ML/IA, estadística, programación, etc.) e indica el nivel de dominio cuando sea relevante. Para puestos sénior, destaca las técnicas de modelado avanzadas y las decisiones de arquitectura junto a las tecnologías concretas. Incluye tanto métodos estadísticos tradicionales como enfoques de ML de vanguardia para demostrar una base teórica sólida combinada con experiencia práctica. La clave es ofrecer una imagen completa pero enfocada de tus capacidades técnicas, teniendo siempre en cuenta los requisitos de los puestos a los que te postulas. Incluye tanto habilidades técnicas como enfoques metodológicos, desde lenguajes de programación concretos hasta diseño experimental y prácticas de despliegue de modelos.
Cómo organizar las habilidades técnicas
Organiza tus habilidades en categorías claras y relevantes para puestos de ciencia de datos:
Machine learning/IA: deep learning, NLP, visión artificial, aprendizaje por refuerzo, análisis de series temporales
Estadística y matemáticas: pruebas estadísticas, diseño experimental, métodos bayesianos, álgebra lineal
Lenguajes de programación: Python (PyTorch, TensorFlow, scikit-learn), R (tidyverse, caret), SQL
Big data y nube: Spark, Hadoop, AWS (SageMaker), GCP (Vertex AI), Azure ML
Visualización de datos: Tableau, Power BI, Matplotlib, Seaborn, D3.js
MLOps y herramientas: Docker, Git, MLflow, Kubeflow, DVC, Weights & Biases
Competencias técnicas avanzadas
Para puestos sénior, incluye competencias técnicas de alto nivel que demuestren un dominio profundo:
Machine learning: diseño de arquitecturas de modelos, transfer learning, few-shot learning, AutoML
MLOps: monitoreo de modelos, pruebas A/B, feature stores, registro de modelos
Big data: computación distribuida, diseño de pipelines de datos, procesamiento en streaming
Investigación: implementación de artículos científicos, diseño experimental, revisión bibliográfica
Prácticas de desarrollo: CI/CD para ML, revisión de código, documentación
Habilidades blandas para científicos de datos
Incluye las habilidades no técnicas esenciales en ciencia de datos:
Comunicación: storytelling con datos, redacción técnica, presentaciones para stakeholders
Gestión de proyectos: Agile/Scrum, planificación de sprints, asignación de recursos
Visión de negocio: análisis del ROI, definición de KPI, recopilación de requisitos
Liderazgo: mentoría de equipos, colaboración entre áreas, planificación de proyectos
Resolución de problemas: contraste de hipótesis, análisis de causa raíz, diseño de soluciones
Sección de experiencia laboral
Tu experiencia laboral debe mostrar una progresión en complejidad técnica e impacto en el negocio con logros concretos y cuantificables. Cada puesto debe demostrar tu capacidad para convertir lo que revelan los datos en valor de negocio y destacar tu experiencia técnica en machine learning y analítica. Céntrate en los proyectos que llevaste de principio a fin, desde la definición del problema hasta el despliegue y el monitoreo del modelo. Incluye datos sobre el volumen de datos procesados, las métricas de rendimiento de los modelos y el impacto logrado en el negocio. Demuestra que sabes trabajar en todo el ciclo de vida del machine learning, desde la recopilación y el preprocesamiento de datos hasta el despliegue y el mantenimiento de modelos. En cada puesto, destaca no solo qué tecnologías usaste, sino por qué las elegiste y qué resultados dieron.
Ejemplo de experiencia en un puesto sénior
Para puestos sénior, destaca el liderazgo, la responsabilidad de los proyectos de principio a fin y el impacto en el negocio.
Científico de datos sénior | AI Solutions Inc. | 2020-actualidad
Responsable de ciencia de datos de una plataforma de inteligencia de clientes que da servicio a empresas de Fortune 500
- Diseñé y desplegué un sistema de recomendaciones que procesa más de 10 millones de interacciones diarias de usuarios, con una mejora del 45% en el CTR
- Dirigí un equipo de 5 científicos de datos en el desarrollo de un modelo de segmentación de clientes que aumentó un 85% el ROI de marketing
- Implanté un pipeline de ML automatizado que redujo el tiempo de entrenamiento de modelos de 1 semana a 6 horas
- Desarrollé un sistema de detección de anomalías en tiempo real con un 96% de precisión en la prevención del fraude
- Establecí prácticas de MLOps que redujeron un 60% el tiempo de despliegue de modelos
Tecnologías: Python, TensorFlow, AWS SageMaker, Spark, MLflow, Docker
Ejemplo de experiencia en un puesto intermedio
Para puestos intermedios, céntrate en la ejecución de proyectos y en tu creciente impacto técnico.
Científico de datos | StartupTech | 2018-2020
Científico de datos en una plataforma de analítica predictiva
- Creé y desplegué un modelo de predicción de abandono de clientes con un 88% de precisión
- Desarrollé un pipeline de NLP que procesa más de 100.000 reseñas de clientes al mes
- Implanté un framework de pruebas A/B que aumentó un 300% la velocidad de experimentación
- Creé un pipeline automatizado de ingeniería de características que redujo un 50% el tiempo de desarrollo de modelos
- Colaboré con el equipo de ingeniería para poner en producción 5 modelos de ML
Habilidades clave: Python, scikit-learn, NLP, pruebas A/B, feature engineering
Ingeniero de machine learning | Tech Solutions | 2016-2018
Ingeniero de ML en sistemas de recomendación
- Creé un motor de recomendaciones que aumentó un 35% la interacción de los usuarios
- Optimicé el pipeline de entrenamiento de modelos y reduje los costos un 40%
- Implanté una API de predicción en tiempo real que gestiona más de 10.000 solicitudes por segundo
- Desarrollé un sistema de monitoreo de la calidad de los datos que redujo un 70% los problemas de datos
Enfoque principal: sistemas de recomendación, despliegue de modelos, desarrollo de API
Proyectos y logros técnicos
Tu sección de proyectos debe mostrar tu capacidad para resolver problemas complejos de ciencia de datos y lograr un impacto medible en el negocio. Cada proyecto debe contar una historia completa: el problema de negocio que abordaste, el enfoque técnico, las decisiones de modelado y los resultados cuantificables. Céntrate en proyectos que demuestren experiencia en áreas relevantes como machine learning, análisis estadístico e ingeniería de datos. Incluye proyectos profesionales y personales que muestren iniciativa y creatividad técnica. En cada proyecto, detalla el ciclo de vida completo del machine learning, incluida la preparación de datos, la selección del modelo, la estrategia de validación y el despliegue. Esta sección debe mostrar no solo lo que creaste, sino cómo abordaste retos analíticos complejos y qué aprendiste.
Cómo presentar tus proyectos
Cada proyecto debe explicar con claridad el problema resuelto, la metodología usada y los resultados cuantificables.
Sistema de predicción de abandono de clientes
Problema: una alta tasa de abandono de clientes causaba pérdidas de ingresos de más de $2 M al año
- Desarrollé un modelo ensemble de ML con un 88% de precisión en la predicción del abandono de clientes
- Implanté un pipeline automatizado de ingeniería de características que procesa más de 50 métricas de comportamiento de clientes
- Reduje un 35% el abandono de clientes con estrategias de intervención específicas
- Desplegué el modelo mediante una API REST que atiende más de 10.000 predicciones diarias
Tecnologías: Python, scikit-learn, XGBoost, FastAPI, PostgreSQL
Análisis de sentimiento del mercado en tiempo real
Problema: el procesamiento manual de los datos de sentimiento del mercado retrasaba las decisiones de trading
- Creé un pipeline de NLP que procesa más de 100.000 noticias financieras al día
- Logré un 92% de precisión en la clasificación de sentimiento con un modelo basado en BERT
- Reduje la latencia del análisis de sentimiento de horas a segundos
- Implanté una arquitectura de streaming para obtener información del mercado en tiempo real
Tecnologías: Python, PyTorch, Kafka, Elasticsearch, Docker
Logros en investigación y competiciones
Destaca tu investigación académica y tus éxitos en competiciones de ciencia de datos.
Investigación publicada: “Novel Approaches to Few-Shot Learning in Computer Vision”, con más de 100 citas
Competiciones de Kaggle: 2 medallas de oro en retos de NLP, en el 1% superior del ranking
Patente en trámite: “Método eficiente para la detección de anomalías en tiempo real en series temporales”
Código abierto: creé una popular librería de aumento de datos con más de 10.000 estrellas en GitHub
Reconocimiento del sector: premio al mejor artículo en la ML Conference 2023
Educación y certificaciones técnicas
La sección de educación de un científico de datos debe destacar tanto la base teórica como las aplicaciones prácticas. Céntrate en asignaturas relevantes de estadística, machine learning e informática. Si tienes un posgrado, destaca tu trabajo de investigación y las publicaciones que demuestren experiencia en ámbitos concretos. Elige certificaciones técnicas que muestren dominio de las herramientas y plataformas estándar del sector. No incluyas solo el nombre de la certificación: añade también los proyectos o implementaciones importantes que surgieron de esos conocimientos. Destaca los proyectos académicos con análisis de datos reales, colaboraciones con empresas o aplicaciones innovadoras de machine learning. Esta sección debe demostrar tanto tu comprensión teórica como tu capacidad para aplicar conceptos analíticos avanzados a problemas prácticos.
Cómo presentar tu educación
Presenta tu educación destacando las asignaturas y la investigación relevantes.
Doctorado en Aprendizaje Automático | Universidad Tecnológica | 2018-2022 • Tesis doctoral: “Técnicas avanzadas de aprendizaje autosupervisado para visión artificial” • 3 artículos publicados en congresos de ML de primer nivel (NeurIPS, ICML) • Líneas de investigación: deep learning, visión artificial, transfer learning • Proyectos clave: - Desarrollé un nuevo algoritmo de few-shot learning con resultados de estado del arte (SOTA) - Creé técnicas eficientes de aumento de datos para conjuntos de datos limitados - Colaboré con empresas en aplicaciones reales de ML
Máster en Ciencia de Datos | Universidad Estatal | 2016-2018 • Promedio (GPA): 3,95/4,0 • Asignaturas relevantes: machine learning avanzado, teoría del aprendizaje estadístico, deep learning • Tesis: “Métodos eficientes para el análisis de series temporales a gran escala” • Premios: premio a la mejor investigación de posgrado, beca de ciencia de datos
Certificaciones profesionales
Incluye certificaciones que demuestren experiencia en las tecnologías y metodologías relevantes.
Certificación AWS Machine Learning Specialty
Google Cloud Professional Data Engineer
TensorFlow Developer Certificate
Databricks Certified Machine Learning Professional
Deep Learning Specialization (deeplearning.ai)
Optimización y formato del CV
El CV de un científico de datos debe equilibrar la profundidad técnica con la claridad, y ser compatible tanto con los ATS como con los lectores humanos. Para ello, cuida el formato y optimiza las palabras clave propias de los puestos de ciencia de datos. Usa títulos de sección estándar e incluye de forma natural términos de machine learning y estadística en todo el CV. El diseño debe guiar al lector por tu progresión en ciencia de datos y mantener la información clave fácil de escanear. Ten en cuenta el perfil técnico de quien lo lee: incluye suficiente detalle para demostrar tu experiencia, pero con descripciones que un reclutador sin perfil técnico pueda entender. Cuida la coherencia del formato, sobre todo en los términos técnicos y las métricas. Usa una fuente limpia y profesional, y deja suficiente espacio en blanco para facilitar la lectura. No olvides incluir enlaces a tu perfil de GitHub, tu cuenta de Kaggle o tus publicaciones, con un formato correcto tanto para la versión digital como para la impresa.
Optimización para ATS en puestos de ciencia de datos
Asegúrate de que tu CV supere los sistemas de seguimiento de candidatos (ATS) sin perder legibilidad.
Incluye términos clave de ML/IA de las ofertas de empleo (por ejemplo, “machine learning”, “deep learning”, “redes neuronales”)
Usa títulos de sección estándar (Experiencia, Habilidades, Educación)
Escribe el nombre completo de cada sigla al menos una vez (por ejemplo, “procesamiento del lenguaje natural (NLP)”)
Evita las tablas y los formatos complejos que puedan confundir a los ATS
Incluye tanto nombres de herramientas como conceptos (por ejemplo, “PyTorch”, “redes neuronales convolucionales”)
Incluye las certificaciones con su nombre completo y abreviado (por ejemplo, “AWS Certified Solutions Architect - Associate (AWS-SAA)”)
Buenas prácticas para el CV de ciencia de datos
Da formato a tu CV para mostrar con eficacia tu experiencia analítica y técnica.
Empieza con métricas de impacto (tasas de precisión, mejoras de rendimiento, impacto en el negocio)
Incluye enlaces a artículos publicados, repositorios de GitHub y perfiles de Kaggle
Organiza los proyectos por tipo (ingeniería de ML, investigación, analítica)
Destaca tanto las habilidades técnicas como el impacto en el negocio
Usa la notación matemática justa y que sea clara
Usa un formato coherente para las métricas de rendimiento de los modelos
Errores comunes en el CV de ciencia de datos
Evita estos errores habituales en los CV de ciencia de datos:
Enumerar algoritmos sin mostrar aplicaciones prácticas
Centrarse en las herramientas en lugar de en la forma de resolver problemas
No explicar el impacto de los modelos en el negocio
Usar demasiada jerga técnica en el resumen profesional
Omitir las métricas de rendimiento de los modelos y las estrategias de validación
No demostrar la gestión de proyectos de principio a fin


















Haz que tu experiencia sea imposible de ignorar.
Crea un CV compatible con ATS y adaptado a la oferta, añade una carta de presentación a juego y ten todo listo para postularte en minutos.
4.58/5
Más de 49.000 candidatos
Empieza gratis · Sin tarjeta de crédito