Szczegółowy poradnik: jak napisać CV na stanowisko Data Scientist
Zobacz ten przykład CV na stanowisko data scientist, a potem stwórz z AI wersję pod konkretną ofertę albo sprawdź ocenę swojego obecnego CV.
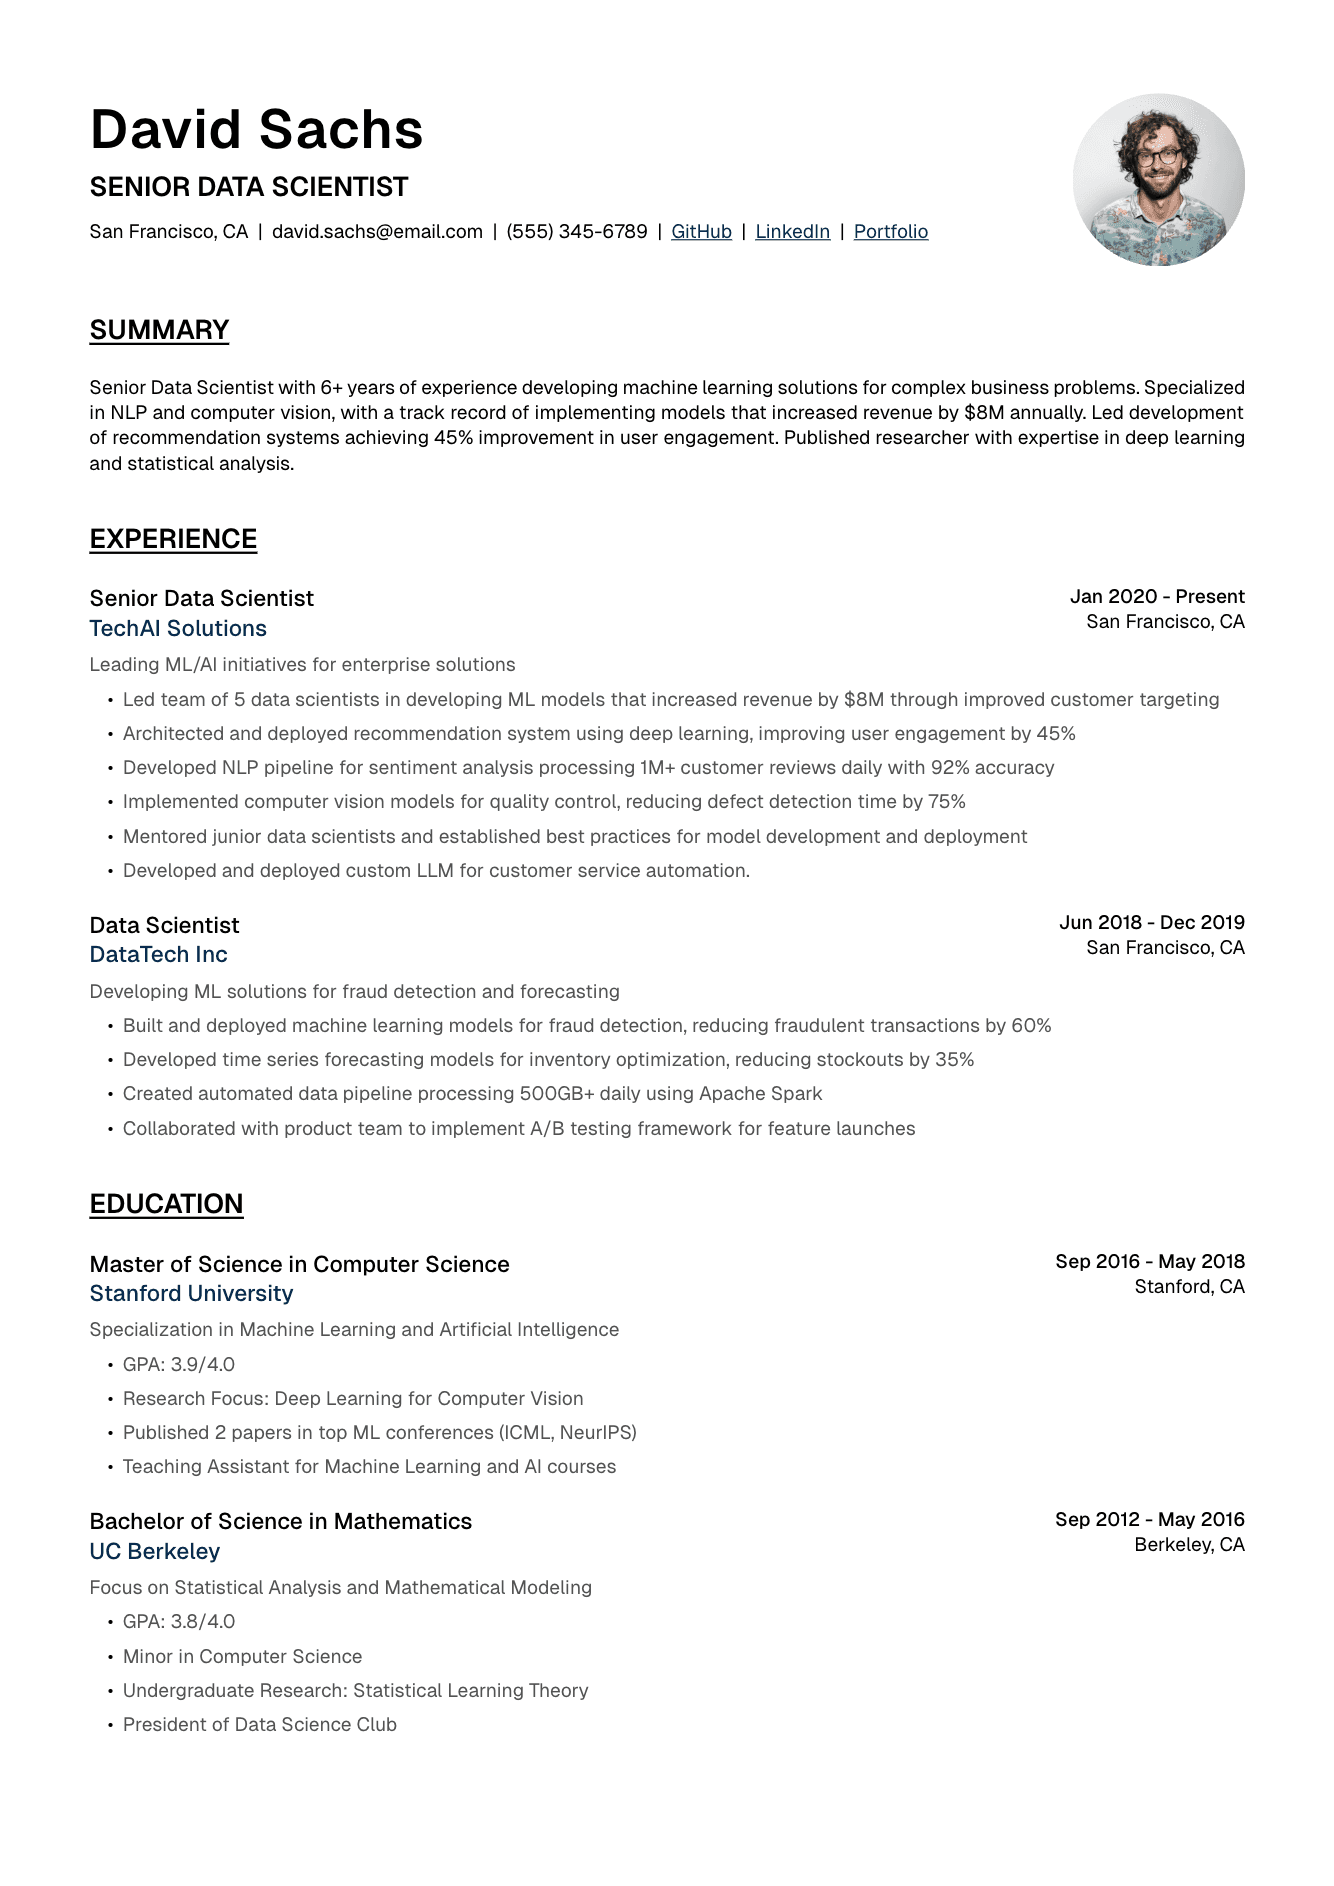
Podsumowanie zawodowe dla Data Scientista
Podsumowanie zawodowe Data Scientista powinno łączyć wiedzę techniczną ze zmysłem biznesowym i od razu pokazywać, że potrafisz wyciągać ze złożonych danych wnioski, na podstawie których można działać. Ta sekcja ma przyciągnąć uwagę najważniejszymi projektami, doświadczeniem w modelowaniu i udowodnioną wartością dla biznesu. Na stanowiskach seniorskich podkreśl wdrożone systemy uczenia maszynowego i zespoły, którymi kierujesz; na średnim poziomie skup się na udanych modelach i analizach; na początku kariery pokaż solidne podstawy teoretyczne i projekty praktyczne. Podawaj osiągnięcia w konkretnych liczbach, pisząc jasno i zwięźle. Dopasuj tę sekcję do stanowiska i branży, podkreślając odpowiednie dziedziny i specjalizacje techniczne. Podsumowanie powinno pokazywać nie tylko umiejętności techniczne, ale też to, jak twoje analizy i modele wpłynęły na decyzje i usprawnienia w firmie.
Podsumowanie dla Senior Data Scientista
Na stanowiskach seniorskich podsumowanie powinno podkreślać trzy rzeczy: przywództwo techniczne w uczeniu maszynowym, prowadzenie projektów od początku do końca i wpływ na biznes. Skup się na modelach wdrożonych na produkcję, zespołach, którymi kierujesz, i konkretnych usprawnieniach.
Senior Data Scientist z ponad 8-letnim doświadczeniem w tworzeniu i wdrażaniu rozwiązań uczenia maszynowego na dużą skalę. Kierowanie budową systemu rekomendacji, który dzięki większemu zaangażowaniu użytkowników przyniósł ponad 50 mln USD dodatkowych przychodów. Ekspert w deep learningu i NLP z doświadczeniem w mentoringu zespołów i wdrażaniu praktyk MLOps, które skróciły czas wdrażania modeli o 70%.
Principal Data Scientist specjalizujący się w computer vision i deep learningu. Ponad 10 lat doświadczenia w prowadzeniu inicjatyw AI na dużą skalę, w tym budowa systemu wykrywania obiektów w czasie rzeczywistym, który przetwarza ponad 1 mln obrazów dziennie z dokładnością 98%. Biegłość w PyTorch, TensorFlow i trenowaniu rozproszonym; obniżenie kosztów trenowania modeli o 300 tys. USD rocznie.
Zacznij od najwyższego stanowiska i liczby lat doświadczenia
Wymień konkretne obszary ML i technologie, w których masz największe doświadczenie
Pokaż wpływ w konkretnych liczbach (wzrost przychodów, poprawa dokładności)
Podkreśl zarówno osiągnięcia produktowe, jak i przywódcze
Zmieść się w 4 linijkach, żeby tekst był czytelny
Podsumowanie dla Data Scientista na średnim poziomie
Na średnim poziomie skup się na udanych projektach i rosnącej wiedzy technicznej. Pokaż, że prowadzisz projekty od początku do końca i jakie konkretne problemy techniczne rozwiązujesz.
Data Scientist z 4-letnim doświadczeniem w tworzeniu rozwiązań uczenia maszynowego dla sektora finansowego. Zaprojektowanie i wdrożenie modelu wykrywania nadużyć, który analizuje transakcje o wartości ponad 100 mln USD dziennie z dokładnością 99,5%. Ograniczenie liczby fałszywych alarmów o 40% dzięki nowatorskiemu feature engineeringowi i modelom zespołowym.
Machine Learning Engineer z 3-letnim doświadczeniem, specjalizacja: NLP i analiza tekstu. Kierowanie budową pipeline'u analizy sentymentu, który co miesiąc przetwarza ponad 1 mln opinii klientów z dokładnością 92%. Pięciokrotne przyspieszenie trenowania modeli dzięki trenowaniu rozproszonemu i automatycznemu doborowi cech.
Podsumowanie dla Data Scientista na początku kariery
Na stanowiskach juniorskich skup się na wykształceniu, stażach i projektach. Podkreśl solidne podstawy teoretyczne i ich praktyczne zastosowanie.
Absolwent data science z solidnymi podstawami uczenia maszynowego, statystyki i inżynierii oprogramowania. 2 staże w firmach technologicznych: tworzenie i wdrażanie modeli ML w Pythonie, TensorFlow i AWS. Aktywny uczestnik konkursów Kaggle z 3 medalami i publikacją naukową z przetwarzania języka naturalnego.
Świeżo upieczony magister data science z praktycznym doświadczeniem w uczeniu maszynowym zdobytym w projektach badawczych i na stażach. Model przewidywania odejść klientów z dokładnością 85%, który według prognoz pozwoli zaoszczędzić 200 tys. USD rocznie. Biegła znajomość Pythona, R i SQL oraz umiejętność szybkiego opanowywania nowych technologii.
Pokaż przydatne przedmioty i projekty badawcze
Podkreśl staże i swój konkretny wkład
Pokaż osiągnięcia w konkursach i projekty własne
Pokaż chęć ciągłej nauki
Wymień konkretne technologie i frameworki ML, których używasz
Stwórz takie CV na stanowisko data scientist
Potraktuj ten przykład jako punkt wyjścia, a potem dopasuj treść, słowa kluczowe i układ do oferty pracy, na którą aplikujesz.
Sekcja umiejętności technicznych
Sekcja umiejętności technicznych Data Scientista musi pokazać zarówno szerokość, jak i głębokość wiedzy z uczenia maszynowego, statystyki i programowania, a przy tym być zgodna z ATS. Pogrupuj umiejętności według obszarów (ML/AI, statystyka, programowanie itd.) i tam, gdzie to ma sens, podaj poziom zaawansowania. Na stanowiskach seniorskich obok konkretnych technologii podkreśl zaawansowane techniki modelowania i decyzje architektoniczne. Uwzględnij zarówno klasyczne metody statystyczne, jak i najnowsze podejścia ML, żeby pokazać solidne podstawy teoretyczne i praktyczną wiedzę. Chodzi o pełny, ale skupiony obraz twoich umiejętności technicznych, zawsze dopasowany do wymagań stanowiska, o które się starasz. Uwzględnij twarde umiejętności techniczne i metody pracy, od konkretnych języków programowania po projektowanie eksperymentów i wdrażanie modeli.
Jak pogrupować umiejętności techniczne
Podziel umiejętności na jasne kategorie ważne na stanowiskach w data science:
Uczenie maszynowe/AI: deep learning, NLP, computer vision, uczenie ze wzmocnieniem, analiza szeregów czasowych
Statystyka i matematyka: testy statystyczne, projektowanie eksperymentów, metody bayesowskie, algebra liniowa
Języki programowania: Python (PyTorch, TensorFlow, scikit-learn), R (tidyverse, caret), SQL
Big data i chmura: Spark, Hadoop, AWS (SageMaker), GCP (Vertex AI), Azure ML
Wizualizacja danych: Tableau, Power BI, Matplotlib, Seaborn, D3.js
MLOps i narzędzia: Docker, Git, MLflow, Kubeflow, DVC, Weights & Biases
Zaawansowane kompetencje techniczne
Na stanowiskach seniorskich wymień zaawansowane kompetencje, które pokazują głęboką wiedzę:
Uczenie maszynowe: projektowanie architektury modeli, transfer learning, few-shot learning, AutoML
MLOps: monitorowanie modeli, testy A/B, feature store, rejestr modeli
Big data: przetwarzanie rozproszone, projektowanie pipeline'ów danych, przetwarzanie strumieniowe
Badania: implementacja artykułów naukowych, projektowanie eksperymentów, przegląd literatury
Praktyki programistyczne: CI/CD dla ML, code review, dokumentacja
Umiejętności miękkie Data Scientista
Wymień najważniejsze umiejętności nietechniczne potrzebne w data science:
Komunikacja: opowiadanie danymi (data storytelling), pisanie dokumentacji technicznej, prezentacje dla interesariuszy
Zarządzanie projektami: Agile/Scrum, planowanie sprintów, alokacja zasobów
Zmysł biznesowy: analiza ROI, definiowanie KPI, zbieranie wymagań
Przywództwo: mentoring zespołu, współpraca międzydziałowa, planowanie projektów
Rozwiązywanie problemów: testowanie hipotez, analiza przyczyn źródłowych, projektowanie rozwiązań
Sekcja doświadczenia zawodowego
Sekcja doświadczenia zawodowego musi pokazywać, jak rośnie złożoność techniczna twojej pracy i jej wpływ na biznes, poprzez konkretne osiągnięcia w liczbach. Każde stanowisko powinno pokazywać, że potrafisz zamieniać wnioski z danych w wartość dla firmy, i podkreślać twoją wiedzę z uczenia maszynowego i analityki. Skup się na prowadzeniu projektów od początku do końca, od zdefiniowania problemu po wdrożenie i monitorowanie modelu. Podaj skalę przetwarzanych danych, wyniki modeli i osiągnięty wpływ na biznes. Pokaż, że działasz w całym cyklu życia modelu ML, od zbierania i przygotowania danych po wdrożenie i utrzymanie. Przy każdym stanowisku napisz nie tylko, jakich technologii używasz, ale też dlaczego je wybierasz i jakie dają wyniki.
Przykład doświadczenia na stanowisku seniorskim
Na stanowiskach seniorskich podkreśl przywództwo, prowadzenie projektów od początku do końca i wpływ na biznes.
Senior Data Scientist | AI Solutions Inc. | 2020-obecnie
Główny Data Scientist platformy analityki klientów obsługującej firmy z listy Fortune 500
- Zaprojektowanie i wdrożenie systemu rekomendacji przetwarzającego ponad 10 mln interakcji użytkowników dziennie, z poprawą CTR o 45%
- Kierowanie 5-osobowym zespołem Data Scientistów przy budowie modelu segmentacji klientów, który zwiększył ROI marketingu o 85%
- Wdrożenie zautomatyzowanego pipeline'u ML, który skrócił trenowanie modelu z 1 tygodnia do 6 godzin
- Budowa systemu wykrywania anomalii w czasie rzeczywistym z dokładnością 96% w zapobieganiu nadużyciom
- Wprowadzenie praktyk MLOps, które skróciły czas wdrażania modeli o 60%
Technologie: Python, TensorFlow, AWS SageMaker, Spark, MLflow, Docker
Przykład doświadczenia na średnim poziomie
Na średnim poziomie skup się na realizacji projektów i rosnącym wpływie technicznym.
Data Scientist | StartupTech | 2018-2020
Data Scientist w zespole platformy analityki predykcyjnej
- Budowa i wdrożenie modelu przewidywania odejść klientów z dokładnością 88%
- Stworzenie pipeline'u NLP przetwarzającego ponad 100 tys. opinii klientów miesięcznie
- Wdrożenie frameworka testów A/B, który zwiększył tempo prowadzenia eksperymentów o 300%
- Stworzenie zautomatyzowanego pipeline'u feature engineeringu, który skrócił czas budowy modeli o 50%
- Współpraca z zespołem inżynierów przy wdrożeniu 5 modeli ML na produkcję
Kluczowe umiejętności: Python, scikit-learn, NLP, testy A/B, feature engineering
Machine Learning Engineer | Tech Solutions | 2016-2018
Inżynier ML w zespole systemów rekomendacji
- Budowa silnika rekomendacji, który zwiększył zaangażowanie użytkowników o 35%
- Optymalizacja pipeline'u trenowania modeli, która obniżyła koszty o 40%
- Wdrożenie API predykcji w czasie rzeczywistym obsługującego ponad 10 tys. zapytań na sekundę
- Stworzenie systemu monitorowania jakości danych, który ograniczył problemy z danymi o 70%
Główny obszar: systemy rekomendacji, wdrażanie modeli, tworzenie API
Projekty i osiągnięcia techniczne
Sekcja projektów powinna pokazywać, że potrafisz rozwiązywać złożone problemy data science i osiągać mierzalne wyniki biznesowe. Każdy projekt powinien opowiadać pełną historię: jaki problem biznesowy rozwiązano, jakie podejście techniczne przyjęto, jakie decyzje dotyczące modelowania podjęto i jakie wyniki w liczbach osiągnięto. Wybierz projekty, które pokazują wiedzę w ważnych obszarach, takich jak uczenie maszynowe, analiza statystyczna i inżynieria danych. Uwzględnij projekty zawodowe i własne, które pokazują inicjatywę i kreatywność techniczną. Przy każdym projekcie opisz pełny cykl życia modelu ML: przygotowanie danych, wybór modelu, strategię walidacji i kwestie wdrożenia. Ta sekcja ma pokazać nie tylko, co budujesz, ale też jak podchodzisz do złożonych problemów analitycznych i czego się przy tym uczysz.
Jak przedstawić projekty
Każdy projekt powinien jasno pokazywać rozwiązany problem, zastosowaną metodę i wyniki w liczbach.
System przewidywania odejść klientów
Problem: wysoki odsetek odejść klientów powodujący ponad 2 mln USD strat w przychodach rocznie
- Stworzenie zespołowego modelu ML przewidującego odejścia klientów z dokładnością 88%
- Wdrożenie zautomatyzowanego pipeline'u feature engineeringu przetwarzającego ponad 50 wskaźników zachowań klientów
- Ograniczenie odejść klientów o 35% dzięki ukierunkowanym działaniom retencyjnym
- Wdrożenie modelu przez REST API obsługujące ponad 10 tys. predykcji dziennie
Technologie: Python, scikit-learn, XGBoost, FastAPI, PostgreSQL
Analiza nastrojów rynkowych w czasie rzeczywistym
Problem: ręczne przetwarzanie danych o nastrojach rynkowych opóźniające decyzje inwestycyjne
- Budowa pipeline'u NLP przetwarzającego ponad 100 tys. artykułów z wiadomościami finansowymi dziennie
- Dokładność klasyfikacji sentymentu na poziomie 92% dzięki modelowi opartemu na BERT
- Skrócenie czasu analizy sentymentu z godzin do sekund
- Wdrożenie architektury strumieniowej dostarczającej wnioski rynkowe w czasie rzeczywistym
Technologie: Python, PyTorch, Kafka, Elasticsearch, Docker
Osiągnięcia naukowe i konkursowe
Pokaż badania naukowe i sukcesy w konkursach data science.
Publikacja naukowa: „Novel Approaches to Few-Shot Learning in Computer Vision”, ponad 100 cytowań
Konkursy Kaggle: 2 złote medale w zadaniach NLP, miejsce w top 1% rankingu
Zgłoszenie patentowe: „Efficient Method for Real-time Anomaly Detection in Time Series Data”
Open source: autor popularnej biblioteki do augmentacji danych z ponad 10 tys. gwiazdek na GitHubie
Wyróżnienia branżowe: nagroda Best Paper Award na ML Conference 2023
Wykształcenie i certyfikaty techniczne
Sekcja wykształcenia Data Scientista powinna pokazywać zarówno podstawy teoretyczne, jak i praktyczne zastosowania. Wymień przedmioty ze statystyki, uczenia maszynowego i informatyki. Przy wyższych stopniach naukowych podkreśl badania i publikacje, które pokazują wiedzę w konkretnych dziedzinach. Dobierz certyfikaty tak, by pokazywały biegłość w standardowych narzędziach i platformach branżowych. Podaj nie tylko nazwy certyfikatów, ale też ważne projekty lub wdrożenia, które powstały dzięki tej wiedzy. Wyróżnij projekty akademickie oparte na prawdziwych danych, współpracę z partnerami z branży i nowatorskie zastosowania uczenia maszynowego. Ta sekcja ma pokazać zarówno rozumienie teorii, jak i umiejętność stosowania zaawansowanych metod analitycznych w praktyce.
Jak przedstawić wykształcenie
Przedstaw wykształcenie, podkreślając przydatne przedmioty i badania.
Doktorat z uczenia maszynowego | Politechnika | 2018-2022 • Rozprawa doktorska: „Advanced Techniques in Self-Supervised Learning for Computer Vision” • 3 publikacje na czołowych konferencjach ML (NeurIPS, ICML) • Obszar badań: deep learning, computer vision, transfer learning • Najważniejsze projekty: - Nowy algorytm few-shot learning z wynikami na poziomie SOTA - Wydajne techniki augmentacji danych dla małych zbiorów danych - Współpraca z partnerami z branży przy praktycznych zastosowaniach ML
Magister data science | Uniwersytet stanowy | 2016-2018 • Średnia ocen (GPA): 3,95/4,0 • Wybrane przedmioty: zaawansowane uczenie maszynowe, statystyczna teoria uczenia, deep learning • Praca magisterska: „Wydajne metody analizy szeregów czasowych na dużą skalę” • Nagrody: wyróżnienie za wybitne badania na studiach magisterskich, stypendium w dziedzinie data science
Certyfikaty zawodowe
Wymień certyfikaty, które potwierdzają wiedzę o ważnych technologiach i metodach.
AWS Machine Learning Specialty Certification
Google Cloud Professional Data Engineer
TensorFlow Developer Certificate
Databricks Certified Machine Learning Professional
Deep Learning Specialization (deeplearning.ai)
Optymalizacja i formatowanie CV
CV Data Scientista musi łączyć głębię techniczną z przejrzystością i być czytelne zarówno dla systemów ATS, jak i dla ludzi. Wymaga to przemyślanego formatowania i doboru słów kluczowych typowych dla data science. Używaj standardowych nagłówków sekcji i naturalnie wplataj w całe CV pojęcia z uczenia maszynowego i statystyki. Układ powinien prowadzić czytelnika przez twój rozwój w data science, a najważniejsze informacje powinny być łatwe do znalezienia. Pomyśl o wiedzy technicznej odbiorców: podaj tyle szczegółów, by pokazać swoją wiedzę, ale pisz tak, by rekruter bez wiedzy technicznej zrozumiał opisy. Dbaj o spójne formatowanie, zwłaszcza pojęć technicznych i wskaźników. Wybierz czystą, profesjonalną czcionkę i zostaw dość wolnej przestrzeni, by CV było czytelne. Dodaj linki do profilu GitHub, konta Kaggle lub publikacji naukowych i sprawdź, czy dobrze wyglądają w wersji cyfrowej i wydrukowanej.
Optymalizacja pod ATS na stanowiskach w data science
Zadbaj, żeby CV przeszło przez systemy ATS i pozostało czytelne.
Używaj kluczowych pojęć ML/AI z ofert pracy (np. „uczenie maszynowe”, „deep learning”, „sieci neuronowe”)
Stosuj standardowe nagłówki sekcji (Doświadczenie zawodowe, Umiejętności, Wykształcenie)
Przynajmniej raz rozwiń każdy skrót (np. „przetwarzanie języka naturalnego (NLP)”)
Unikaj tabel i skomplikowanego formatowania, które może zmylić system ATS
Podawaj zarówno nazwy narzędzi, jak i pojęcia (np. „PyTorch”, „konwolucyjne sieci neuronowe”)
Wpisuj pełne i skrócone nazwy certyfikatów (np. „AWS Certified Solutions Architect - Associate (AWS-SAA)”)
Dobre praktyki w CV Data Scientista
Sformatuj CV tak, by dobrze pokazywało twoje umiejętności analityczne i techniczne.
Zaczynaj od mocnych wyników (dokładność, poprawa wydajności, wpływ na biznes)
Dodaj linki do publikacji, repozytoriów na GitHubie i profilu Kaggle
Pogrupuj projekty według typu (inżynieria ML, badania, analityka)
Podkreśl zarówno umiejętności techniczne, jak i wpływ na biznes
Ogranicz zapis matematyczny do minimum i pisz go czytelnie
Formatuj wyniki modeli w spójny sposób
Częste błędy w CV Data Scientista
Unikaj tych częstych błędów w CV z data science:
Wymienianie algorytmów bez pokazania ich praktycznego zastosowania
Skupianie się na narzędziach zamiast na sposobie rozwiązywania problemów
Brak wyjaśnienia, jaki wpływ na biznes miały modele
Nadmiar żargonu technicznego w podsumowaniu
Pomijanie wyników modeli i strategii walidacji
Brak dowodów na prowadzenie projektów od początku do końca


















Pokaż doświadczenie, którego nie da się przeoczyć.
Stwórz CV zgodne z ATS i dopasowane do oferty, przygotuj pasujący list motywacyjny i aplikuj w kilka minut.
4.58/5
Ponad 49 000 osób szukających pracy
Zacznij za darmo · Bez karty kredytowej