Cientista de dados: guia detalhado para escrever seu currículo
Veja este exemplo de currículo de cientista de dados e depois crie com IA uma versão adaptada à vaga ou confira a pontuação do seu currículo atual.
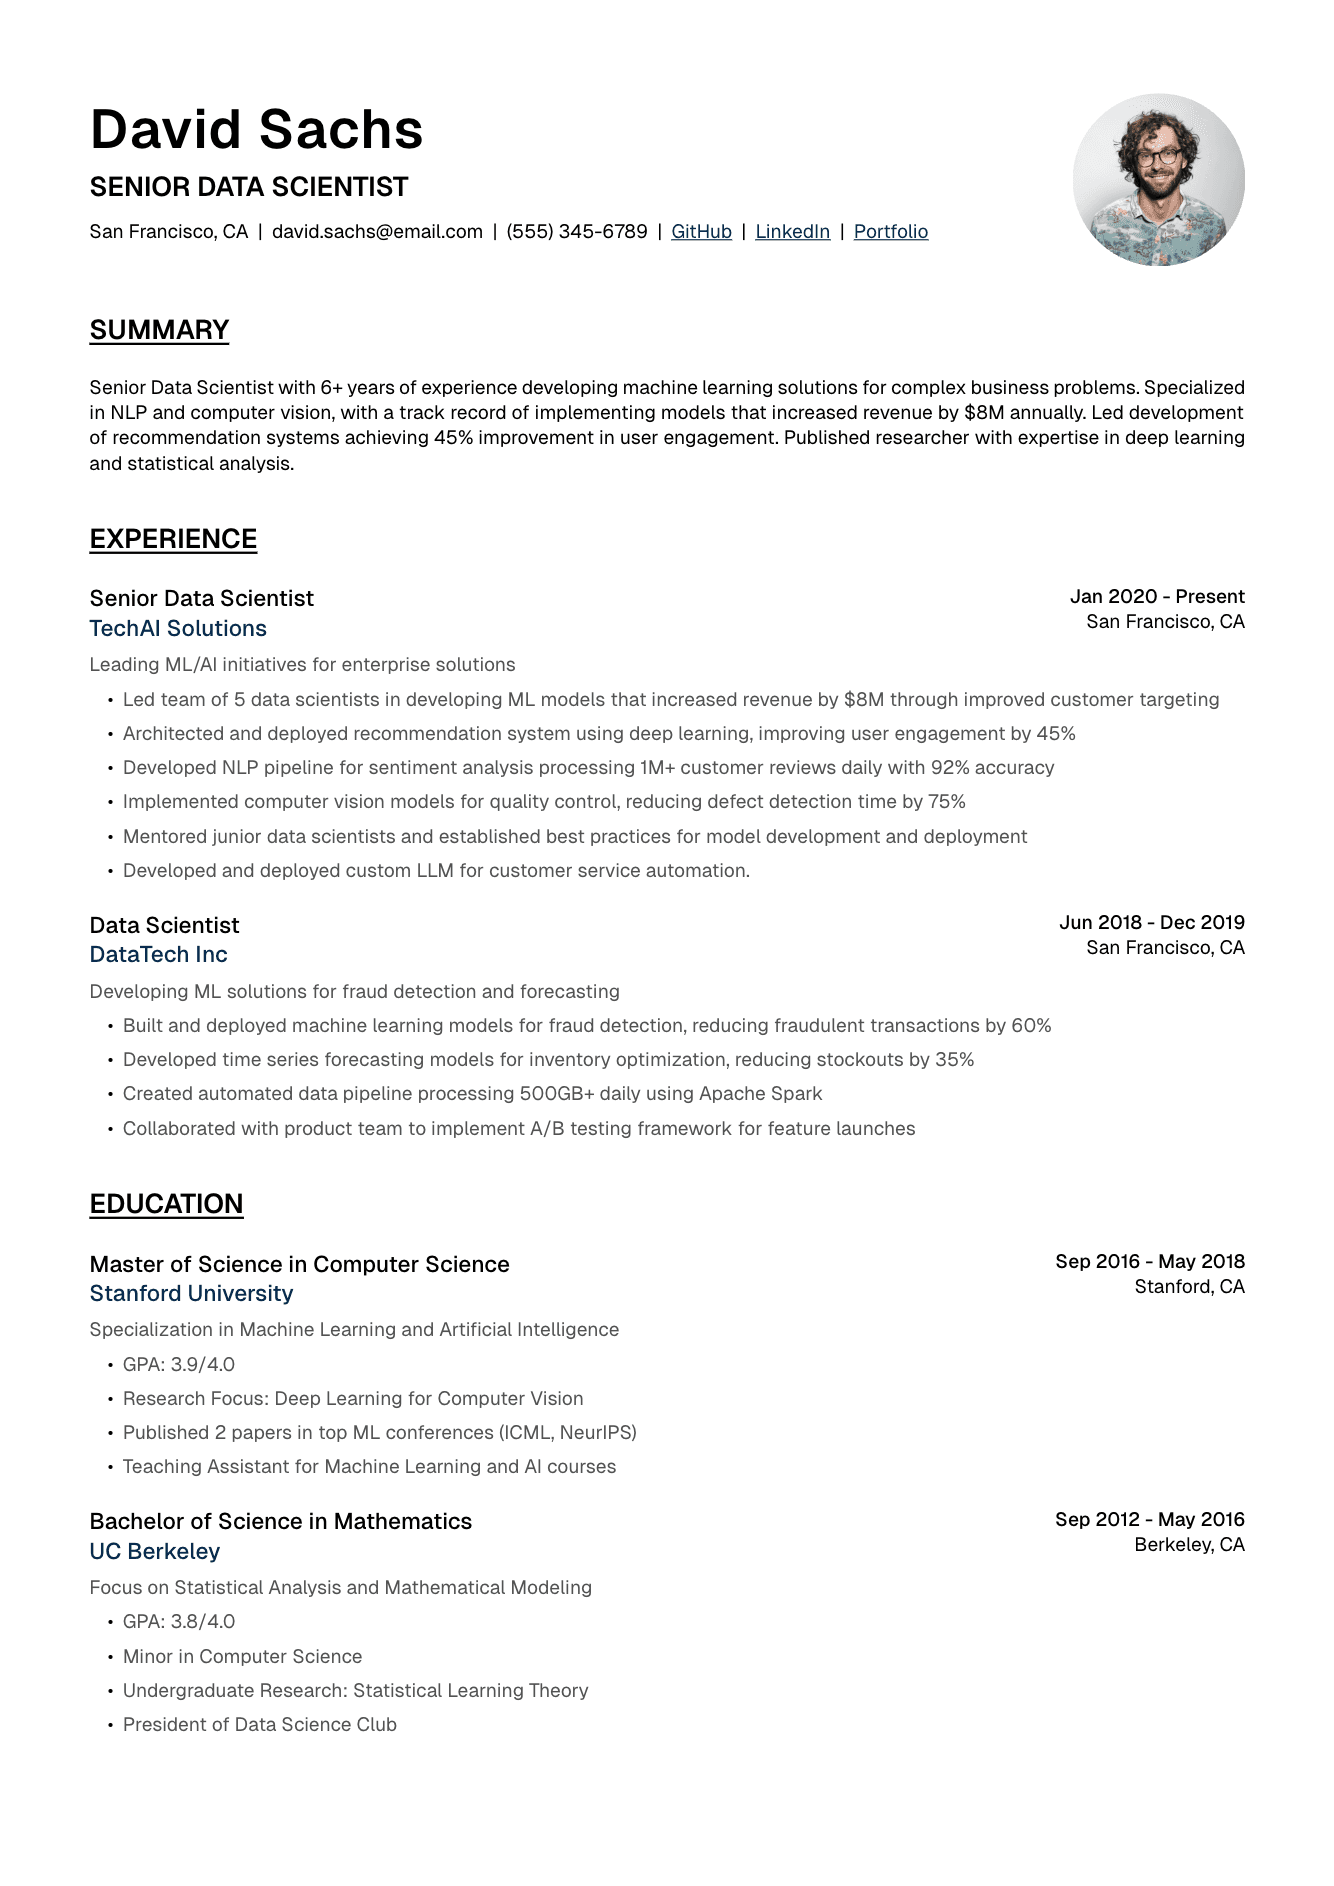
Resumo profissional para cientistas de dados
Como cientista de dados, seu resumo profissional deve equilibrar conhecimento técnico e visão de negócios, mostrando logo de início sua capacidade de extrair insights acionáveis de dados complexos. Esta seção precisa chamar a atenção com seus projetos de maior impacto, sua experiência em modelagem e o valor que você já gerou para o negócio. Para cargos seniores, dê ênfase aos sistemas de machine learning colocados em produção e às equipes que você liderou; para cargos de nível pleno, foque em modelos e análises bem-sucedidos; para cargos de início de carreira, destaque uma base teórica sólida e projetos práticos. Quantifique as conquistas com métricas específicas, sem perder clareza nem impacto. Adapte esta seção ao cargo e ao setor, destacando os domínios e as especialidades técnicas relevantes. O resumo deve mostrar não só suas capacidades técnicas, mas como suas análises e modelos orientaram decisões e melhorias no negócio.
Resumo para cientista de dados sênior
Para cargos seniores, seu resumo deve destacar três pontos-chave: liderança técnica em machine learning, responsabilidade pelos projetos do início ao fim e impacto no negócio. Foque nos modelos colocados em produção, nas equipes lideradas e nas melhorias concretas alcançadas.
Cientista de dados sênior com mais de 8 anos de experiência no desenvolvimento e na implantação de soluções de machine learning em escala. Liderei o desenvolvimento de um motor de recomendação que gerou mais de US$ 50 milhões em receita adicional com o aumento do engajamento dos usuários. Especialista em deep learning e NLP, com histórico comprovado de mentoria de equipes e de implantação de práticas de MLOps que reduziram em 70% o tempo de deploy dos modelos.
Cientista de dados principal, especializado em visão computacional e deep learning. Mais de 10 anos de experiência liderando iniciativas de IA em escala, incluindo o desenvolvimento de um sistema de detecção de objetos em tempo real que processa mais de 1 milhão de imagens por dia com 98% de acurácia. Especialista em PyTorch, TensorFlow e treinamento distribuído, com redução de US$ 300 mil por ano nos custos de treinamento de modelos.
Comece pelo seu cargo mais alto e seus anos de experiência
Cite os domínios de ML e as tecnologias em que você se destaca
Quantifique o impacto com métricas concretas (aumento de receita, ganhos de acurácia)
Destaque conquistas de produto e também de liderança
Use no máximo 4 linhas para facilitar a leitura
Resumo para cientista de dados pleno
Cientistas de dados de nível pleno devem focar em projetos bem-sucedidos e no crescimento técnico. Destaque os projetos que você conduziu do início ao fim e os desafios técnicos específicos que resolveu.
Cientista de dados com 4 anos de experiência no desenvolvimento de soluções de machine learning para serviços financeiros. Projetei e implantei um modelo de detecção de fraudes que processa mais de US$ 100 milhões em transações por dia com 99,5% de acurácia. Reduzi em 40% os falsos positivos com feature engineering inovadora e técnicas de modelagem ensemble.
Engenheiro de machine learning com 3 anos de experiência, especializado em NLP e análise de texto. Liderei o desenvolvimento de um pipeline de análise de sentimento que processa mais de 1 milhão de avaliações de clientes por mês com 92% de acurácia. Tornei o treinamento de modelos 5 vezes mais eficiente com treinamento distribuído e seleção automatizada de features.
Resumo para cientista de dados em início de carreira
Para vagas de início de carreira, foque na sua formação, nos estágios e nos projetos. Dê ênfase à sua base teórica sólida e às aplicações práticas.
Formado em Ciência de Dados, com base sólida em machine learning, estatística e engenharia de software. Fiz 2 estágios em empresas de tecnologia, desenvolvendo e implantando modelos de ML com Python, TensorFlow e AWS. Participante ativo de competições no Kaggle, com 3 medalhas e pesquisa publicada em processamento de linguagem natural.
Mestre em Ciência de Dados recém-formado, com experiência prática em machine learning em vários projetos de pesquisa e estágios. Desenvolvi um modelo de previsão de churn com 85% de acurácia, com economia anual projetada de US$ 200 mil. Domínio de Python, R e SQL e facilidade comprovada para aprender novas tecnologias rapidamente.
Destaque disciplinas e projetos de pesquisa relevantes
Dê ênfase aos estágios e às suas contribuições concretas
Mostre conquistas em competições e projetos pessoais
Mostre vontade de aprender continuamente
Cite as tecnologias e os frameworks de ML que você usou
Crie seu currículo de cientista de dados com base neste exemplo
Use este exemplo como ponto de partida e depois adapte o conteúdo, as palavras-chave e o layout à descrição da vaga a que você está se candidatando.
Seção de competências técnicas
A seção de competências técnicas de um cientista de dados deve mostrar, de forma estratégica, amplitude e profundidade em machine learning, estatística e programação, sem deixar de ser compatível com ATS. Organize as competências por área (ML/IA, estatística, programação etc.) e indique o nível de domínio quando fizer sentido. Para cargos seniores, destaque técnicas avançadas de modelagem e decisões de arquitetura, junto com as tecnologias específicas. Inclua métodos estatísticos tradicionais e abordagens de ML de ponta para mostrar uma base teórica sólida combinada com experiência prática. O segredo é apresentar um retrato completo, mas focado, das suas capacidades técnicas, sempre de acordo com os requisitos das vagas que você busca. Lembre-se de incluir competências técnicas e abordagens metodológicas, de linguagens de programação específicas a desenho de experimentos e práticas de deploy de modelos.
Como organizar as competências técnicas
Organize suas competências em categorias claras e relevantes para cargos de ciência de dados:
Machine learning/IA: deep learning, NLP, visão computacional, aprendizado por reforço, análise de séries temporais
Estatística e matemática: testes estatísticos, desenho de experimentos, métodos bayesianos, álgebra linear
Linguagens de programação: Python (PyTorch, TensorFlow, scikit-learn), R (tidyverse, caret), SQL
Big data e nuvem: Spark, Hadoop, AWS (SageMaker), GCP (Vertex AI), Azure ML
Visualização de dados: Tableau, Power BI, Matplotlib, Seaborn, D3.js
MLOps e ferramentas: Docker, Git, MLflow, Kubeflow, DVC, Weights & Biases
Competências técnicas avançadas
Para cargos seniores, inclua competências técnicas de alto nível que mostrem conhecimento profundo:
Machine learning: design de arquitetura de modelos, transfer learning, few-shot learning, AutoML
MLOps: monitoramento de modelos, testes A/B, feature stores, registro de modelos
Big data: computação distribuída, design de pipelines de dados, processamento de streaming
Pesquisa: implementação de artigos científicos, desenho de experimentos, revisão de literatura
Práticas de desenvolvimento: CI/CD para ML, code review, documentação
Competências comportamentais para cientistas de dados
Inclua as competências não técnicas essenciais para cargos de ciência de dados:
Comunicação: data storytelling, redação técnica, apresentações para stakeholders
Gestão de projetos: Agile/Scrum, planejamento de sprints, alocação de recursos
Visão de negócios: análise de ROI, definição de KPIs, levantamento de requisitos
Liderança: mentoria de equipes, colaboração entre áreas, planejamento de projetos
Resolução de problemas: testes de hipóteses, análise de causa raiz, desenho de soluções
Seção de experiência profissional
Sua seção de experiência profissional precisa mostrar evolução na complexidade técnica e no impacto no negócio, com conquistas concretas e quantificáveis. Cada cargo deve mostrar sua capacidade de transformar insights de dados em valor para o negócio, destacando sua experiência técnica em machine learning e analytics. Foque nos projetos que você conduziu do início ao fim, da definição do problema ao deploy e monitoramento do modelo. Inclua detalhes sobre o volume de dados processados, as métricas de desempenho dos modelos e o impacto alcançado no negócio. Mostre que você atua em todo o ciclo de vida de machine learning, da coleta e pré-processamento dos dados ao deploy e à manutenção dos modelos. Em cada cargo, destaque não só as tecnologias que você usou, mas por que as escolheu e que resultados elas trouxeram.
Exemplo de experiência: cargo sênior
Para cargos seniores, dê ênfase à liderança, à responsabilidade pelos projetos do início ao fim e ao impacto no negócio.
Cientista de dados sênior | AI Solutions Inc. | 2020-atual
Cientista de dados líder da plataforma de inteligência de clientes que atende empresas da Fortune 500
- Projetei e implantei um sistema de recomendação que processa mais de 10 milhões de interações de usuários por dia, com melhora de 45% no CTR
- Liderei uma equipe de 5 cientistas de dados no desenvolvimento de um modelo de segmentação de clientes que aumentou em 85% o ROI de marketing
- Implementei um pipeline automatizado de ML que reduziu o tempo de treinamento dos modelos de 1 semana para 6 horas
- Desenvolvi um sistema de detecção de anomalias em tempo real com 96% de acurácia na prevenção de fraudes
- Implantei práticas de MLOps que reduziram em 60% o tempo de deploy dos modelos
Tecnologias: Python, TensorFlow, AWS SageMaker, Spark, MLflow, Docker
Exemplo de experiência: cargo pleno
Para cargos de nível pleno, foque na execução de projetos e no seu impacto técnico crescente.
Cientista de dados | StartupTech | 2018-2020
Cientista de dados de uma plataforma de análise preditiva
- Criei e implantei um modelo de previsão de churn com 88% de acurácia
- Desenvolvi um pipeline de NLP que processa mais de 100 mil avaliações de clientes por mês
- Implementei um framework de testes A/B que aumentou em 300% a velocidade dos experimentos
- Criei um pipeline automatizado de feature engineering que reduziu em 50% o tempo de desenvolvimento dos modelos
- Colaborei com a equipe de engenharia para colocar 5 modelos de ML em produção
Principais competências: Python, scikit-learn, NLP, testes A/B, feature engineering
Engenheiro de machine learning | Tech Solutions | 2016-2018
Engenheiro de ML focado em sistemas de recomendação
- Criei um motor de recomendação que aumentou em 35% o engajamento dos usuários
- Otimizei o pipeline de treinamento de modelos, reduzindo os custos em 40%
- Implementei uma API de previsão em tempo real que processa mais de 10 mil requisições por segundo
- Desenvolvi um sistema de monitoramento da qualidade dos dados que reduziu em 70% os problemas de dados
Foco principal: sistemas de recomendação, deploy de modelos, desenvolvimento de APIs
Projetos e conquistas técnicas
Sua seção de projetos deve mostrar sua capacidade de resolver problemas complexos de ciência de dados e entregar impacto mensurável no negócio. Cada projeto deve contar uma história completa: o problema de negócio abordado, a abordagem técnica adotada, as decisões de modelagem tomadas e os resultados quantificáveis alcançados. Foque em projetos que mostrem domínio de áreas relevantes como machine learning, análise estatística e engenharia de dados. Inclua projetos profissionais e pessoais que mostrem iniciativa e criatividade técnica. Para cada projeto, detalhe o ciclo de vida completo de machine learning, incluindo preparação dos dados, escolha do modelo, estratégia de validação e cuidados com o deploy. Esta seção deve mostrar não só o que você construiu, mas como você encarou desafios analíticos complexos e o que aprendeu com eles.
Como apresentar projetos
Cada projeto deve comunicar com clareza o problema resolvido, a metodologia usada e os resultados quantificáveis.
Sistema de previsão de churn de clientes
Problema: alta taxa de churn causando perda de mais de US$ 2 milhões em receita por ano
- Desenvolvi um modelo ensemble de ML com 88% de acurácia na previsão de churn
- Implementei um pipeline automatizado de feature engineering que processa mais de 50 métricas de comportamento dos clientes
- Reduzi o churn em 35% com estratégias de intervenção direcionadas
- Coloquei o modelo em produção via API REST, com mais de 10 mil previsões por dia
Tecnologias: Python, scikit-learn, XGBoost, FastAPI, PostgreSQL
Análise de sentimento do mercado em tempo real
Problema: o processamento manual de dados de sentimento do mercado atrasava as decisões de trading
- Criei um pipeline de NLP que processa mais de 100 mil notícias financeiras por dia
- Alcancei 92% de acurácia na classificação de sentimento com um modelo baseado em BERT
- Reduzi a latência da análise de sentimento de horas para segundos
- Implementei uma arquitetura de streaming para insights de mercado em tempo real
Tecnologias: Python, PyTorch, Kafka, Elasticsearch, Docker
Conquistas em pesquisa e competições
Destaque pesquisas acadêmicas e resultados em competições de ciência de dados.
Pesquisa publicada: “Novel Approaches to Few-Shot Learning in Computer Vision”, com mais de 100 citações
Competições no Kaggle: 2 medalhas de ouro em desafios de NLP, entre os 1% melhores do ranking
Pedido de patente: “Método eficiente para detecção de anomalias em tempo real em dados de séries temporais”
Código aberto: criei uma biblioteca popular de data augmentation com mais de 10 mil estrelas no GitHub
Reconhecimento no setor: prêmio de melhor artigo (Best Paper Award) na ML Conference 2023
Formação acadêmica e certificações técnicas
A seção de formação de um cientista de dados deve destacar tanto a base teórica quanto as aplicações práticas. Foque em disciplinas relevantes de estatística, machine learning e ciência da computação. Em mestrados e doutorados, destaque pesquisas e publicações que mostrem domínio de áreas específicas. Escolha as certificações técnicas de forma estratégica, para mostrar domínio das ferramentas e plataformas padrão do mercado. Inclua não só o nome das certificações, mas também os projetos ou implementações relevantes que resultaram desse conhecimento. Lembre-se de destacar projetos acadêmicos que envolveram análise de dados reais, parcerias com empresas ou aplicações inovadoras de machine learning. Esta seção deve mostrar tanto seu entendimento teórico quanto sua capacidade de aplicar conceitos analíticos avançados a problemas práticos.
Como apresentar a formação
Apresente sua formação com ênfase nas disciplinas e pesquisas relevantes.
Doutorado em Machine Learning | Universidade de Tecnologia | 2018-2022 • Tese: “Técnicas avançadas de aprendizado autossupervisionado para visão computacional” • 3 artigos publicados em conferências de ML de primeira linha (NeurIPS, ICML) • Linhas de pesquisa: deep learning, visão computacional, transfer learning • Principais projetos: - Desenvolvi um novo algoritmo de few-shot learning com resultados no estado da arte (SOTA) - Criei técnicas eficientes de data augmentation para conjuntos de dados limitados - Colaborei com empresas parceiras em aplicações reais de ML
Mestrado em Ciência de Dados | Universidade Estadual | 2016-2018 • GPA (média geral): 3,95/4,0 • Disciplinas relevantes: Machine Learning Avançado, Teoria do Aprendizado Estatístico, Deep Learning • Dissertação: “Métodos eficientes para análise de séries temporais em larga escala” • Prêmios: Prêmio de Destaque em Pesquisa na Pós-Graduação, Bolsa em Ciência de Dados
Certificações profissionais
Liste certificações que comprovem domínio das tecnologias e metodologias relevantes.
Certificação AWS Machine Learning Specialty
Google Cloud Professional Data Engineer
TensorFlow Developer Certificate
Databricks Certified Machine Learning Professional
Deep Learning Specialization (deeplearning.ai)
Otimização e formatação do currículo
O currículo de um cientista de dados precisa equilibrar profundidade técnica e clareza, e ainda funcionar bem tanto no ATS quanto para quem o lê. Isso exige uma formatação estratégica e palavras-chave específicas de ciência de dados. Use títulos de seção padrão do mercado e inclua com naturalidade termos de machine learning e estatística ao longo do currículo. O layout deve conduzir o leitor pela sua evolução em ciência de dados e deixar as informações mais importantes fáceis de encontrar numa leitura rápida. Pense no conhecimento técnico de quem vai ler: inclua detalhes suficientes para mostrar domínio, mas mantenha as descrições acessíveis para recrutadores sem formação técnica. Cuide da consistência da formatação, principalmente nos termos técnicos e nas métricas. Use uma fonte limpa e profissional e deixe espaço em branco suficiente para facilitar a leitura. Lembre-se de incluir links para seu perfil no GitHub, sua conta no Kaggle ou suas publicações, formatados corretamente tanto para a versão digital quanto para a impressa.
Otimização para ATS em cargos de ciência de dados
Garanta que seu currículo passe pelos sistemas de rastreamento de candidatos (ATS) sem perder a legibilidade.
Inclua os principais termos de ML/IA das descrições de vaga (por exemplo, “machine learning”, “deep learning”, “redes neurais”)
Use títulos de seção padrão (Experiência profissional, Competências, Educação)
Escreva as siglas por extenso pelo menos uma vez (por exemplo, “processamento de linguagem natural (NLP)”)
Evite tabelas e formatações complexas que possam confundir o ATS
Inclua nomes de ferramentas e também conceitos (por exemplo, “PyTorch”, “redes neurais convolucionais”)
Liste as certificações com o nome completo e a sigla (por exemplo, “AWS Certified Solutions Architect - Associate (AWS-SAA)”)
Boas práticas para currículo de ciência de dados
Formate seu currículo para mostrar bem sua experiência analítica e técnica.
Comece pelas métricas de impacto (taxas de acurácia, ganhos de desempenho, impacto no negócio)
Inclua links para artigos publicados, repositórios no GitHub e perfis no Kaggle
Organize os projetos por tipo (engenharia de ML, pesquisa, analytics)
Destaque tanto as competências técnicas quanto o impacto no negócio
Use pouca notação matemática, e sempre de forma clara
Use uma formatação consistente para as métricas de desempenho dos modelos
Erros comuns em currículos de ciência de dados
Evite estes erros comuns em currículos de ciência de dados:
Listar algoritmos sem mostrar aplicações práticas
Focar nas ferramentas em vez da forma de resolver problemas
Não explicar o impacto dos modelos no negócio
Usar jargão técnico em excesso em resumos executivos
Omitir métricas de desempenho dos modelos e estratégias de validação
Não mostrar que você conduziu projetos do início ao fim


















Torne sua experiência impossível de ignorar.
Crie um currículo compatível com ATS e adaptado à vaga, faça uma carta de apresentação que combine com ele e candidate-se em poucos minutos.
4,58/5
49.000+ candidatos
Comece grátis · Sem cartão de crédito