Ausführlicher Ratgeber: So schreibst du deinen Lebenslauf als Data Scientist
Sieh dir dieses Beispiel für einen Lebenslauf als Data Scientist an. Erstelle dann mit KI eine Version für deine Stelle oder prüfe den Score deines aktuellen Lebenslaufs.
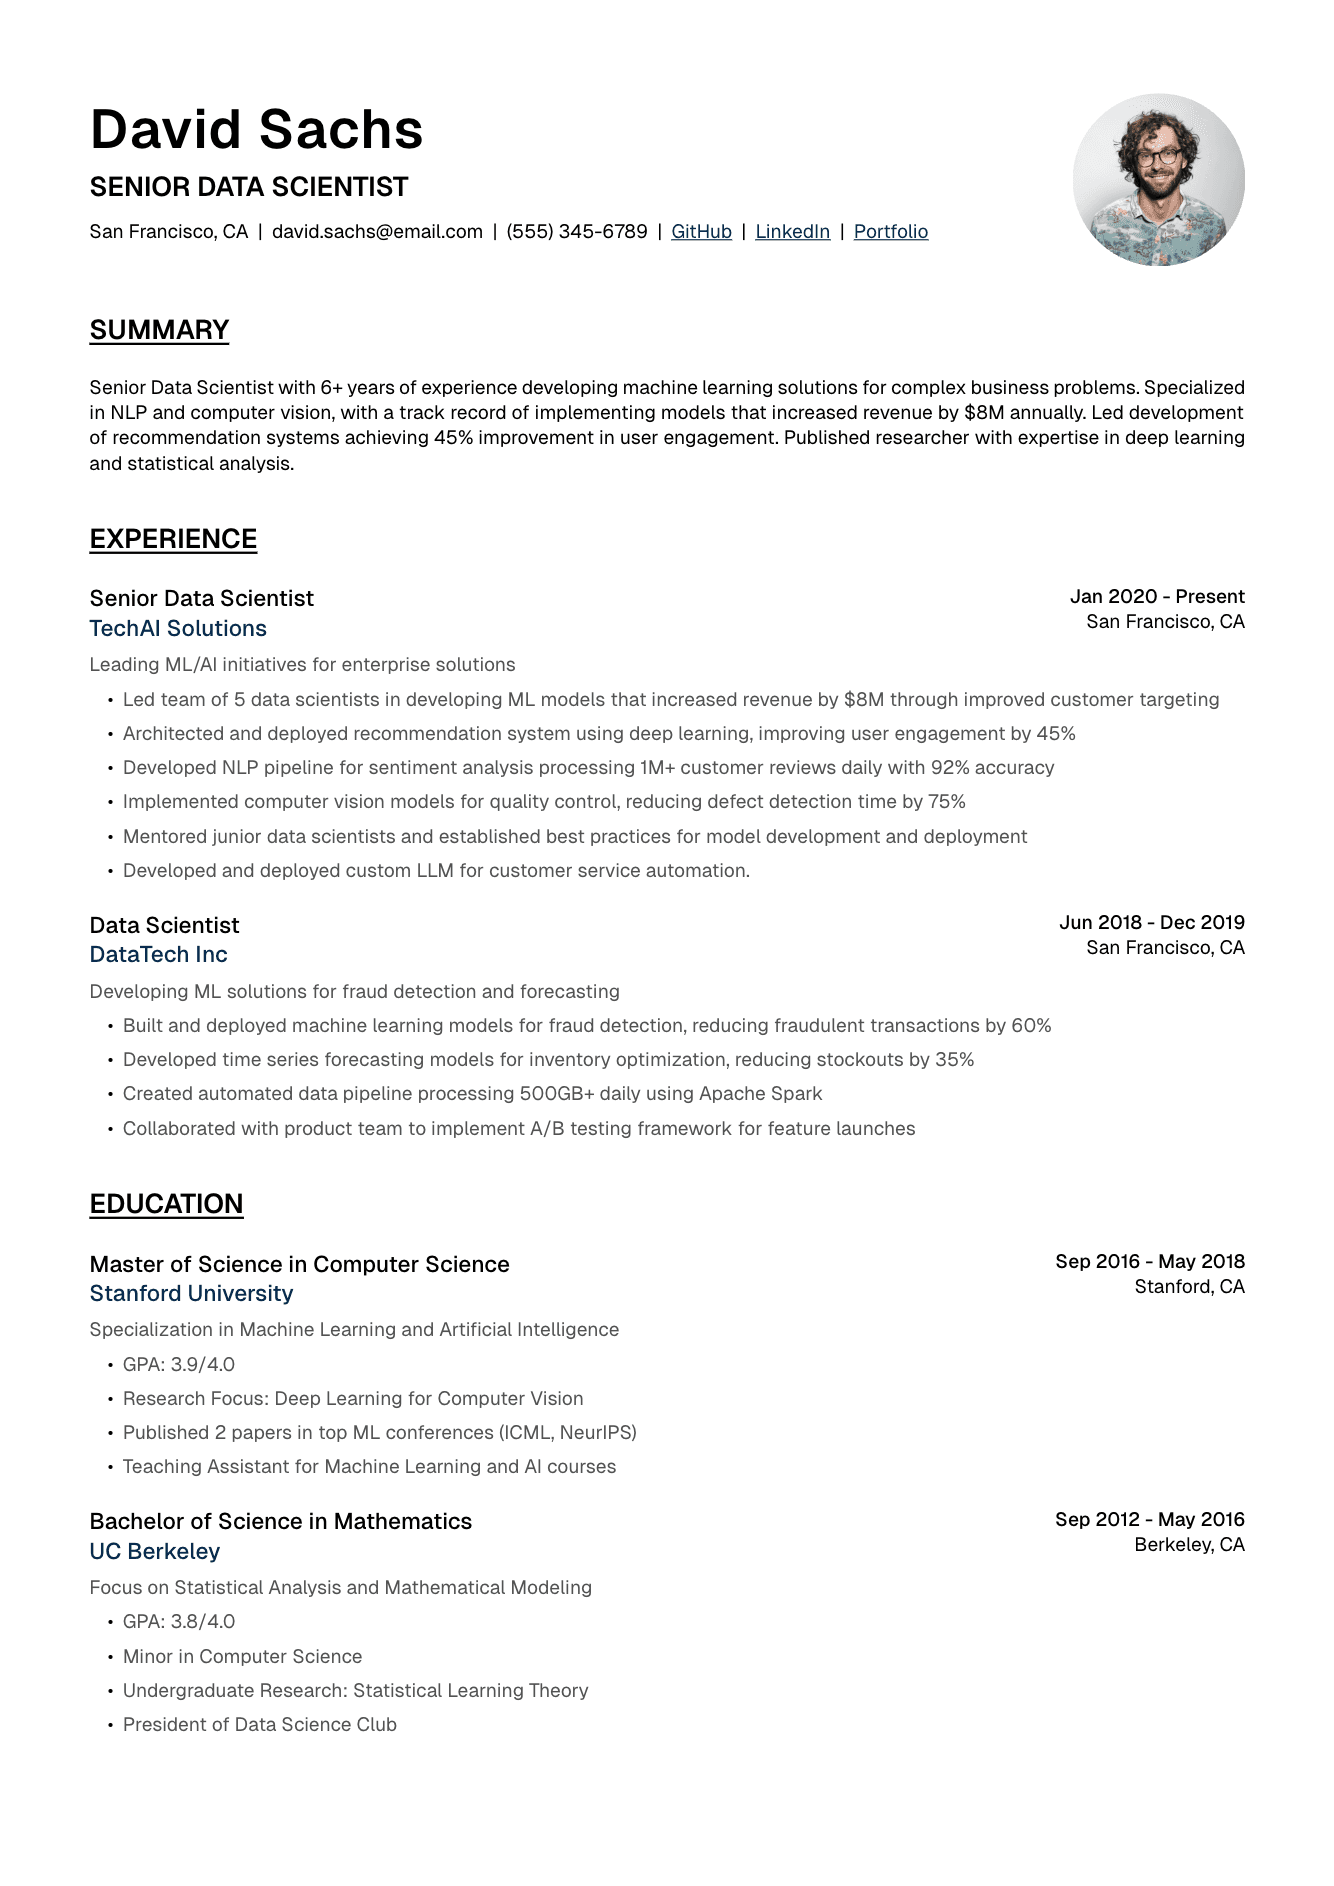
Kurzprofil für Data Scientists
Als Data Scientist sollte dein Kurzprofil technisches Know-how und Geschäftssinn verbinden und sofort zeigen, dass du aus komplexen Daten verwertbare Erkenntnisse gewinnst. Dieser Abschnitt muss Aufmerksamkeit wecken, indem er deine wirkungsvollsten Projekte, deine Expertise in der Modellierung und deinen nachgewiesenen geschäftlichen Beitrag zeigt. Bei Senior-Positionen betonst du produktiv eingesetzte Machine-Learning-Systeme und geführte Teams, auf mittlerer Ebene erfolgreiche Modelle und Analysen, beim Berufseinstieg solide theoretische Grundlagen und praktische Projekte. Belege Erfolge mit konkreten Kennzahlen und bleib dabei klar und prägnant. Passe diesen Abschnitt an Position und Branche an und hebe passende Fachgebiete und technische Schwerpunkte hervor. Das Kurzprofil sollte nicht nur deine technischen Fähigkeiten zeigen, sondern auch, wie deine Analysen und Modelle Geschäftsentscheidungen und Verbesserungen bewirkt haben.
Kurzprofil für Senior Data Scientists
Bei Senior-Positionen sollte dein Kurzprofil drei Punkte betonen: technische Führung im Machine Learning, Verantwortung für Projekte von Anfang bis Ende und geschäftliche Wirkung. Konzentriere dich auf produktiv eingesetzte Modelle, geführte Teams und konkrete Verbesserungen.
Senior Data Scientist mit über 8 Jahren Erfahrung in Entwicklung und Deployment skalierbarer Machine-Learning-Lösungen. Entwicklung einer Recommendation Engine geleitet, die durch höheres Nutzerengagement über 50 Mio. $ zusätzlichen Umsatz brachte. Expertise in Deep Learning und NLP, mit nachweislicher Erfahrung im Mentoring von Teams und in der Einführung von MLOps-Praktiken, die die Deployment-Zeit von Modellen um 70 % verkürzten.
Principal Data Scientist mit Schwerpunkt Computer Vision und Deep Learning. Über 10 Jahre Erfahrung in der Leitung großer KI-Initiativen, u. a. Entwicklung eines Echtzeit-Systems zur Objekterkennung, das täglich über 1 Mio. Bilder mit 98 % Genauigkeit verarbeitet. Expertise in PyTorch, TensorFlow und verteiltem Training, Trainingskosten der Modelle um 300.000 $ pro Jahr gesenkt.
Beginne mit deinem höchsten Jobtitel und deinen Berufsjahren
Nenne konkrete ML-Bereiche und Technologien, in denen du stark bist
Belege deine Wirkung mit konkreten Kennzahlen (Umsatzsteigerung, höhere Genauigkeit)
Zeige Erfolge bei Produkten und in der Führung
Halte es unter 4 Zeilen, damit es gut lesbar bleibt
Kurzprofil auf mittlerer Karrierestufe
Auf mittlerer Ebene konzentrierst du dich auf erfolgreiche Projekte und wachsendes technisches Know-how. Zeige, dass du Projekte von Anfang bis Ende verantwortest, und nenne konkrete technische Probleme, die du gelöst hast.
Data Scientist mit 4 Jahren Erfahrung in der Entwicklung von Machine-Learning-Lösungen für Finanzdienstleister. Konzeption und Deployment eines Modells zur Betrugserkennung, das täglich Transaktionen von über 100 Mio. $ mit 99,5 % Genauigkeit verarbeitet. False Positives durch neue Ansätze im Feature Engineering und Ensemble-Modellierung um 40 % reduziert.
Machine Learning Engineer mit 3 Jahren Erfahrung, spezialisiert auf NLP und Textanalyse. Entwicklung einer Pipeline zur Sentiment-Analyse geleitet, die monatlich über 1 Mio. Kundenbewertungen mit 92 % Genauigkeit verarbeitet. Effizienz des Modelltrainings durch verteiltes Training und automatisierte Feature-Auswahl um das 5-Fache gesteigert.
Kurzprofil für den Berufseinstieg
Beim Berufseinstieg konzentrierst du dich auf Studium, Praktika und Projekte. Betone solide theoretische Grundlagen und ihre praktische Anwendung.
Data-Science-Absolvent mit soliden Grundlagen in Machine Learning, Statistik und Softwareentwicklung. 2 Praktika in Tech-Unternehmen absolviert, dabei ML-Modelle mit Python, TensorFlow und AWS entwickelt und bereitgestellt. Aktive Teilnahme an Kaggle-Wettbewerben mit 3 Medaillen sowie veröffentlichte Forschung zu Natural Language Processing.
Master in Data Science (kürzlich abgeschlossen) mit praktischer Erfahrung im Machine Learning aus mehreren Forschungsprojekten und Praktika. Modell zur Vorhersage der Kundenabwanderung mit 85 % Genauigkeit entwickelt, mit prognostizierten jährlichen Einsparungen von 200.000 $. Sichere Kenntnisse in Python, R und SQL, nachweislich schnell im Erlernen neuer Technologien.
Hebe relevante Kurse und Forschungsprojekte hervor
Betone Praktika und deine konkreten Beiträge
Zeige Erfolge in Wettbewerben und eigene Projekte
Zeige, dass du gern dazulernst
Nenne konkrete Technologien und ML-Frameworks, die du genutzt hast
Erstelle deinen Lebenslauf als Data Scientist nach diesem Vorbild
Nimm dieses Beispiel als Ausgangspunkt und passe dann Inhalt, Keywords und Layout an die Stellenanzeige an, auf die du dich bewirbst.
Technische Fähigkeiten
Als Data Scientist muss dein Abschnitt technische Fähigkeiten gezielt Breite und Tiefe in Machine Learning, Statistik und Programmierung zeigen und dabei ATS-freundlich bleiben. Ordne deine Fähigkeiten nach Bereichen (ML/KI, Statistik, Programmierung usw.) und gib bei Bedarf dein Kenntnisniveau an. Bei Senior-Positionen betonst du neben konkreten Technologien fortgeschrittene Modellierungstechniken und Architekturentscheidungen. Nenne klassische statistische Methoden und aktuelle ML-Ansätze, um solide theoretische Grundlagen und praktisches Können zu zeigen. Entscheidend ist ein vollständiges, aber fokussiertes Bild deiner technischen Fähigkeiten, immer mit Blick auf die Anforderungen der Zielposition. Nenne technische Hard Skills und methodische Ansätze, von konkreten Programmiersprachen bis zu Versuchsplanung und Deployment von Modellen.
So ordnest du technische Fähigkeiten
Ordne deine Fähigkeiten in klare Kategorien, die in der Data Science zählen:
Machine Learning/KI: Deep Learning, NLP, Computer Vision, Reinforcement Learning, Zeitreihenanalyse
Statistik und Mathematik: statistische Tests, Versuchsplanung, Bayes-Verfahren, lineare Algebra
Programmiersprachen: Python (PyTorch, TensorFlow, scikit-learn), R (tidyverse, caret), SQL
Big Data und Cloud: Spark, Hadoop, AWS (SageMaker), GCP (Vertex AI), Azure ML
Datenvisualisierung: Tableau, Power BI, Matplotlib, Seaborn, D3.js
MLOps und Tools: Docker, Git, MLflow, Kubeflow, DVC, Weights & Biases
Fortgeschrittene technische Kompetenzen
Bei Senior-Positionen nennst du übergeordnete technische Kompetenzen, die tiefe Expertise zeigen:
Machine Learning: Design von Modellarchitekturen, Transfer Learning, Few-Shot Learning, AutoML
MLOps: Modell-Monitoring, A/B-Tests, Feature Stores, Model Registry
Big Data: verteiltes Rechnen, Design von Datenpipelines, Stream Processing
Forschung: Umsetzung von Fachartikeln, Versuchsplanung, Literaturrecherche
Entwicklungspraxis: CI/CD für ML, Code-Reviews, Dokumentation
Soft Skills für Data Scientists
Nenne wichtige nicht-technische Fähigkeiten, die in der Data Science entscheidend sind:
Kommunikation: Data Storytelling, technisches Schreiben, Präsentationen für Stakeholder
Projektmanagement: Agile/Scrum, Sprintplanung, Ressourcenplanung
Geschäftssinn: ROI-Analyse, KPI-Definition, Anforderungsanalyse
Führung: Mentoring im Team, bereichsübergreifende Zusammenarbeit, Projektplanung
Problemlösung: Hypothesentests, Ursachenanalyse, Lösungsdesign
Berufserfahrung
Dein Abschnitt Berufserfahrung muss mit konkreten, messbaren Erfolgen zeigen, wie technische Komplexität und geschäftliche Wirkung gewachsen sind. Jede Position sollte zeigen, dass du Erkenntnisse aus Daten in geschäftlichen Nutzen übersetzt, und deine technische Expertise in Machine Learning und Analytics hervorheben. Konzentriere dich auf Projekte, die du von Anfang bis Ende verantwortet hast, von der Problemdefinition bis zu Deployment und Monitoring der Modelle. Nenne den Umfang der verarbeiteten Daten, Leistungskennzahlen der Modelle und die erzielte geschäftliche Wirkung. Zeige, dass du den gesamten Machine-Learning-Lebenszyklus abdeckst, von Datenerhebung und Vorverarbeitung bis zu Deployment und Wartung der Modelle. Zeige für jede Position nicht nur, welche Technologien du genutzt hast, sondern auch, warum du sie gewählt hast und welche Ergebnisse sie gebracht haben.
Beispiel für Berufserfahrung auf Senior-Level
Bei Senior-Positionen betonst du Führung, Verantwortung für Projekte von Anfang bis Ende und geschäftliche Wirkung.
Senior Data Scientist | AI Solutions Inc. | 2020–heute
Lead Data Scientist für eine Customer-Intelligence-Plattform mit Fortune-500-Kunden
- Konzeption und Deployment eines Empfehlungssystems, das täglich über 10 Mio. Nutzerinteraktionen verarbeitet, mit 45 % höherer CTR
- Leitung eines Teams aus 5 Data Scientists bei der Entwicklung eines Modells zur Kundensegmentierung, das den Marketing-ROI um 85 % steigerte
- Einführung einer automatisierten ML-Pipeline, die die Trainingszeit der Modelle von 1 Woche auf 6 Stunden verkürzte
- Entwicklung eines Echtzeit-Systems zur Anomalieerkennung mit 96 % Genauigkeit in der Betrugsprävention
- Einführung von MLOps-Praktiken, die die Deployment-Zeit von Modellen um 60 % verkürzten
Technologien: Python, TensorFlow, AWS SageMaker, Spark, MLflow, Docker
Beispiel für Berufserfahrung auf mittlerer Karrierestufe
Auf mittlerer Ebene konzentrierst du dich auf die Umsetzung von Projekten und wachsende technische Wirkung.
Data Scientist | StartupTech | 2018–2020
Data Scientist für eine Plattform für Predictive Analytics
- Entwicklung und Deployment eines Modells zur Vorhersage der Kundenabwanderung mit 88 % Genauigkeit
- Aufbau einer NLP-Pipeline, die monatlich über 100.000 Kundenbewertungen verarbeitet
- Einführung eines Frameworks für A/B-Tests, das das Tempo der Experimente um 300 % steigerte
- Aufbau einer automatisierten Pipeline für Feature Engineering, die die Entwicklungszeit von Modellen um 50 % verkürzte
- Zusammenarbeit mit dem Engineering-Team beim Deployment von 5 ML-Modellen in Produktion
Kernkompetenzen: Python, scikit-learn, NLP, A/B-Tests, Feature Engineering
Machine Learning Engineer | Tech Solutions | 2016–2018
ML Engineer für Empfehlungssysteme
- Aufbau einer Recommendation Engine, die das Nutzerengagement um 35 % steigerte
- Optimierung der Trainingspipeline, die die Kosten um 40 % senkte
- Einführung einer Echtzeit-API für Vorhersagen mit über 10.000 Anfragen pro Sekunde
- Entwicklung eines Monitoringsystems für Datenqualität, das Datenprobleme um 70 % reduzierte
Schwerpunkte: Empfehlungssysteme, Deployment von Modellen, API-Entwicklung
Projekte und technische Erfolge
Dein Abschnitt Projekte sollte zeigen, dass du komplexe Data-Science-Probleme löst und messbare geschäftliche Wirkung erzielst. Jedes Projekt sollte eine vollständige Geschichte erzählen: das geschäftliche Problem, den technischen Ansatz, die Entscheidungen bei der Modellierung und die messbaren Ergebnisse. Konzentriere dich auf Projekte, die Expertise in relevanten Bereichen wie Machine Learning, statistischer Analyse und Data Engineering zeigen. Nenne berufliche und private Projekte, die Eigeninitiative und technische Kreativität zeigen. Beschreibe für jedes Projekt den gesamten Machine-Learning-Lebenszyklus, einschließlich Datenaufbereitung, Modellauswahl, Validierungsstrategie und Überlegungen zum Deployment. Dieser Abschnitt sollte nicht nur zeigen, was du gebaut hast, sondern auch, wie du komplexe analytische Aufgaben angegangen bist und welche Erkenntnisse du gewonnen hast.
So stellst du Projekte dar
Jedes Projekt sollte klar zeigen: das gelöste Problem, die Methode und die messbaren Ergebnisse.
System zur Vorhersage der Kundenabwanderung
Problem: Hohe Abwanderungsrate mit über 2 Mio. $ Umsatzverlust pro Jahr
- Entwicklung eines Ensemble-ML-Modells mit 88 % Genauigkeit bei der Vorhersage der Kundenabwanderung
- Einführung einer automatisierten Feature-Engineering-Pipeline mit über 50 Kennzahlen zum Kundenverhalten
- Senkung der Kundenabwanderung um 35 % durch gezielte Maßnahmen
- Deployment des Modells über eine REST-API mit über 10.000 Vorhersagen pro Tag
Technologien: Python, scikit-learn, XGBoost, FastAPI, PostgreSQL
Echtzeit-Sentiment-Analyse für Finanzmärkte
Problem: Manuelle Auswertung von Daten zur Marktstimmung verzögerte Handelsentscheidungen
- Aufbau einer NLP-Pipeline, die täglich über 100.000 Finanznachrichten verarbeitet
- 92 % Genauigkeit bei der Sentiment-Klassifizierung mit einem BERT-basierten Modell
- Latenz der Sentiment-Analyse von Stunden auf Sekunden reduziert
- Einführung einer Streaming-Architektur für Markteinblicke in Echtzeit
Technologien: Python, PyTorch, Kafka, Elasticsearch, Docker
Erfolge in Forschung und Wettbewerben
Hebe akademische Forschung und Erfolge in Data-Science-Wettbewerben hervor.
Veröffentlichte Forschung: „Novel Approaches to Few-Shot Learning in Computer Vision“, über 100-mal zitiert
Kaggle-Wettbewerbe: 2 Goldmedaillen in NLP-Challenges, Top 1 % im Ranking
Patent angemeldet: „Effizientes Verfahren zur Echtzeit-Anomalieerkennung in Zeitreihendaten“
Open Source: Beliebte Bibliothek für Data Augmentation mit über 10.000 GitHub-Sternen entwickelt
Auszeichnung: Best Paper Award auf der ML Conference 2023
Ausbildung und technische Zertifizierungen
Im Abschnitt Ausbildung zeigst du als Data Scientist theoretische Grundlagen und praktische Anwendung. Konzentriere dich auf relevante Kurse in Statistik, Machine Learning und Informatik. Bei weiterführenden Abschlüssen hebst du Forschungsarbeiten und Veröffentlichungen hervor, die Expertise in bestimmten Bereichen zeigen. Wähle technische Zertifizierungen gezielt aus, damit sie sichere Kenntnisse in branchenüblichen Tools und Plattformen zeigen. Nenne nicht nur die Namen der Zertifizierungen, sondern auch wichtige Projekte oder Umsetzungen, die aus diesem Wissen entstanden sind. Hebe akademische Projekte mit Analysen echter Daten, Kooperationen mit Industriepartnern oder neuartigen Anwendungen von Machine Learning hervor. Dieser Abschnitt sollte dein theoretisches Verständnis zeigen und belegen, dass du fortgeschrittene analytische Konzepte auf praktische Probleme anwenden kannst.
So stellst du deine Ausbildung dar
Stelle deine Ausbildung dar und betone relevante Kurse und Forschung.
Ph.D. in Machine Learning | Tech University | 2018–2022 • Dissertation: „Advanced Techniques in Self-Supervised Learning for Computer Vision“ • 3 Paper auf führenden ML-Konferenzen veröffentlicht (NeurIPS, ICML) • Forschungsschwerpunkte: Deep Learning, Computer Vision, Transfer Learning • Wichtige Projekte: - Neuen Few-Shot-Learning-Algorithmus mit SOTA-Ergebnissen entwickelt - Effiziente Techniken zur Data Augmentation für kleine Datensätze erarbeitet - Zusammenarbeit mit Industriepartnern an ML-Anwendungen aus der Praxis
Master of Science in Data Science | State University | 2016–2018 • Notendurchschnitt (GPA): 3,95/4,0 • Relevante Kurse: Fortgeschrittenes Machine Learning, Statistische Lerntheorie, Deep Learning • Masterarbeit: „Efficient Methods for Large-Scale Time Series Analysis“ • Auszeichnungen: Outstanding Graduate Research Award, Data Science Fellowship
Berufliche Zertifizierungen
Nenne Zertifizierungen, die deine Expertise in relevanten Technologien und Methoden belegen.
AWS Machine Learning Specialty Certification
Google Cloud Professional Data Engineer
TensorFlow Developer Certificate
Databricks Certified Machine Learning Professional
Deep Learning Specialization (deeplearning.ai)
Aufbau und Formatierung des Lebenslaufs
Der Lebenslauf eines Data Scientists muss technische Tiefe und Klarheit verbinden und zugleich für Bewerbermanagementsysteme (ATS) und menschliche Leser funktionieren. Dafür brauchst du eine gezielte Formatierung und Keywords, die zu Data-Science-Jobs passen. Verwende übliche Abschnittsüberschriften und baue passende Begriffe aus Machine Learning und Statistik natürlich in deinen Lebenslauf ein. Das Layout sollte Lesende durch deine Entwicklung in der Data Science führen und wichtige Informationen leicht überfliegbar halten. Denk an den technischen Hintergrund deiner Zielgruppe: Gib genug Details, um deine Expertise zu zeigen, und halte die Beschreibungen für Recruiter ohne technischen Hintergrund verständlich. Achte besonders auf einheitliche Formatierung, vor allem bei Fachbegriffen und Kennzahlen. Wähle eine klare, professionelle Schriftart und lass genug Weißraum, damit der Text gut lesbar ist. Füge Links zu deinem GitHub-Profil, deinem Kaggle-Konto oder deinen Veröffentlichungen hinzu und achte darauf, dass sie digital und gedruckt richtig funktionieren.
ATS-Optimierung für Data-Science-Jobs
Sorge dafür, dass dein Lebenslauf durch das ATS kommt und gut lesbar bleibt.
Übernimm wichtige ML/KI-Begriffe aus der Stellenanzeige (z. B. „Machine Learning“, „Deep Learning“, „neuronale Netze“)
Verwende übliche Abschnittsüberschriften (Berufserfahrung, Fähigkeiten, Ausbildung)
Schreibe Abkürzungen mindestens einmal aus (z. B. „Natural Language Processing (NLP)“)
Verzichte auf Tabellen und komplexe Formatierung, die das ATS verwirren können
Nenne Tool-Namen und Konzepte (z. B. „PyTorch“, „Convolutional Neural Networks“)
Nenne Zertifizierungen mit vollem Namen und Abkürzung (z. B. „AWS Certified Solutions Architect - Associate (AWS-SAA)“)
Best Practices für Data-Science-Lebensläufe
Gestalte deinen Lebenslauf so, dass er deine analytische und technische Expertise zeigt.
Beginne mit starken Kennzahlen (Genauigkeit, Leistungssteigerungen, geschäftliche Wirkung)
Verlinke veröffentlichte Paper, GitHub-Repositorys und Kaggle-Profile
Ordne Projekte nach Art (ML Engineering, Forschung, Analytics)
Zeige technische Fähigkeiten und geschäftliche Wirkung
Halte mathematische Notation knapp und klar
Formatiere Leistungskennzahlen von Modellen einheitlich
Häufige Fehler in Data-Science-Lebensläufen
Vermeide diese typischen Fehler in Data-Science-Lebensläufen:
Algorithmen aufzählen, ohne praktische Anwendungen zu zeigen
Tools in den Vordergrund stellen statt Lösungswege
Nicht erklären, welche geschäftliche Wirkung die Modelle haben
Zu viel Fachjargon im Kurzprofil
Leistungskennzahlen und Validierungsstrategien der Modelle weglassen
Nicht zeigen, dass du Projekte von Anfang bis Ende verantwortest


















Mach deine Erfahrung unübersehbar.
Erstelle einen ATS-freundlichen Lebenslauf, angepasst an die Stelle, und ein passendes Anschreiben. In wenigen Minuten bist du bereit für die Bewerbung.
4,58/5
49.000+ Jobsuchende
Kostenlos starten · Keine Kreditkarte nötig