Data scientist: guida dettagliata per scrivere il CV
Guarda questo esempio di CV da data scientist, poi crea una versione mirata con l'AI o controlla il punteggio del tuo CV attuale.
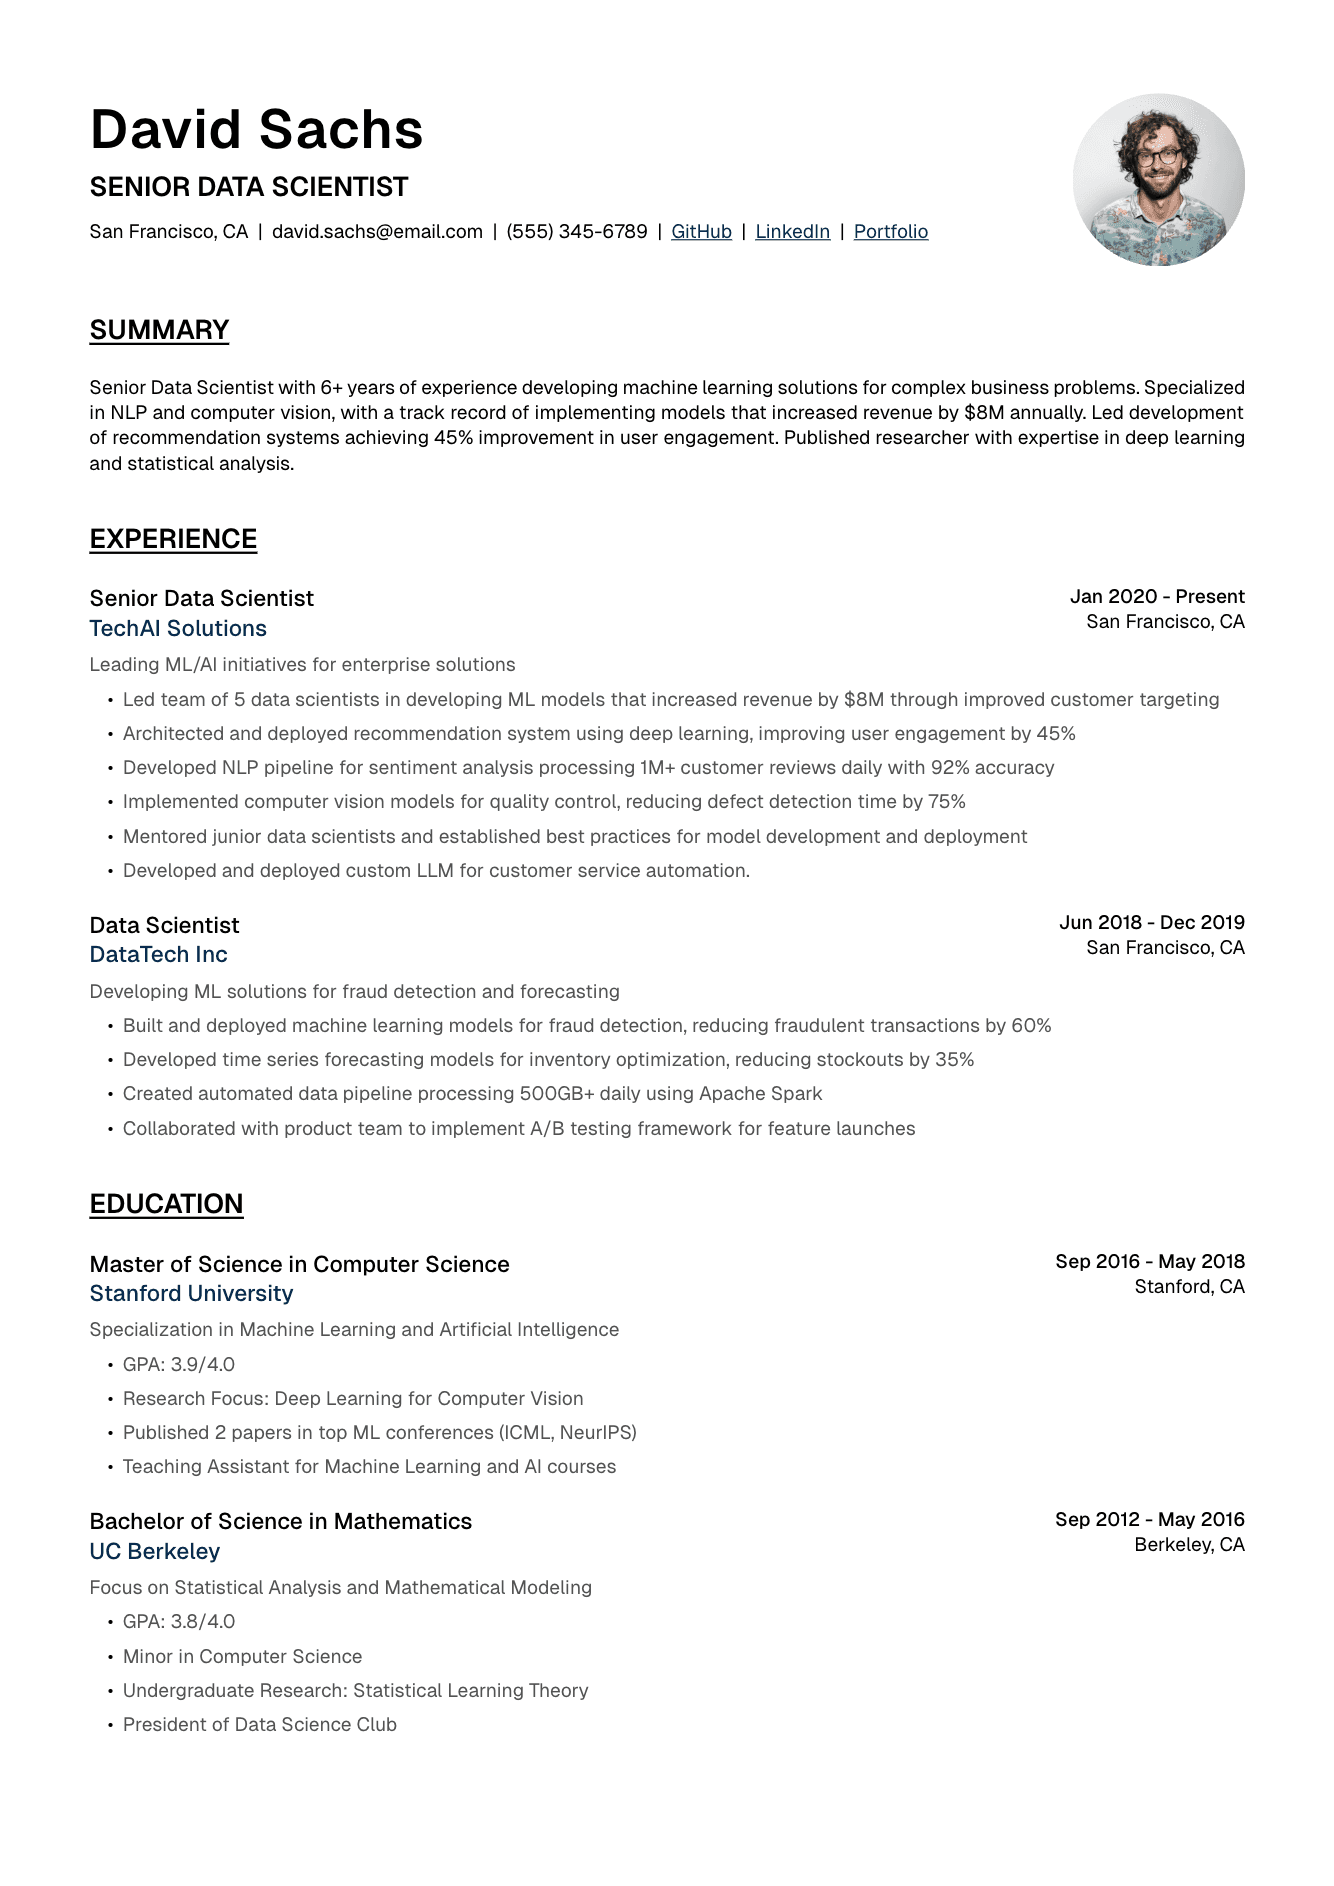
Profilo professionale per data scientist
Come data scientist, il tuo profilo professionale deve bilanciare competenze tecniche e visione di business, mostrando subito che sai ricavare indicazioni utili da dati complessi. Questa sezione deve catturare l'attenzione con i tuoi progetti di maggiore impatto, la tua esperienza nella modellazione e il valore che hai già creato per il business. Per i ruoli senior, punta sui sistemi di machine learning messi in produzione e sui team guidati; per i ruoli intermedi, sui modelli e sulle analisi di successo; per i ruoli junior, sulle solide basi teoriche e sui progetti pratici. Quantifica i risultati con metriche precise, restando chiaro ed efficace. Adatta questa sezione al ruolo e al settore, mettendo in evidenza i domini e le specializzazioni tecniche pertinenti. Il profilo deve mostrare non solo le tue capacità tecniche, ma anche come le tue analisi e i tuoi modelli hanno guidato decisioni e miglioramenti in azienda.
Guida al profilo per data scientist senior
Per i ruoli senior, il profilo deve mettere in risalto tre elementi chiave: leadership tecnica nel machine learning, responsabilità dei progetti dall'inizio alla fine e impatto sul business. Punta sui modelli messi in produzione, sui team guidati e sui miglioramenti concreti ottenuti.
Senior data scientist con oltre 8 anni di esperienza nello sviluppo e nel deployment di soluzioni di machine learning su larga scala. Guida dello sviluppo di un motore di raccomandazione che ha generato oltre 50 milioni di dollari di ricavi aggiuntivi grazie a un maggiore coinvolgimento degli utenti. Esperto di deep learning e NLP, con una comprovata esperienza nel mentoring dei team e nell'introduzione di pratiche MLOps che hanno ridotto del 70% i tempi di deployment dei modelli.
Principal data scientist specializzato in computer vision e deep learning. Oltre 10 anni di esperienza alla guida di iniziative AI su larga scala, tra cui lo sviluppo di un sistema di object detection in tempo reale che elabora oltre 1 milione di immagini al giorno con un'accuratezza del 98%. Esperto di PyTorch, TensorFlow e training distribuito, con una riduzione dei costi di training dei modelli di 300.000 dollari all'anno.
Apri con il tuo ruolo più senior e gli anni di esperienza
Indica i domini di ML e le tecnologie in cui eccelli
Quantifica l'impatto con metriche concrete (aumento dei ricavi, miglioramenti dell'accuratezza)
Metti in evidenza sia i risultati di prodotto sia quelli di leadership
Resta sotto le 4 righe per una lettura facile
Guida al profilo per data scientist di livello intermedio
I data scientist di livello intermedio dovrebbero puntare sui progetti riusciti e sulla crescita delle competenze tecniche. Metti in evidenza i progetti che hai seguito dall'inizio alla fine e le sfide tecniche specifiche che hai risolto.
Data scientist con 4 anni di esperienza nello sviluppo di soluzioni di machine learning per i servizi finanziari. Progettazione e deployment di un modello di rilevamento delle frodi che elabora oltre 100 milioni di dollari di transazioni al giorno con un'accuratezza del 99,5%. Riduzione del 40% dei falsi positivi grazie a tecniche innovative di feature engineering e modelli ensemble.
Machine learning engineer con 3 anni di esperienza, specializzato in NLP e text analytics. Guida dello sviluppo di una pipeline di sentiment analysis che elabora oltre 1 milione di recensioni di clienti al mese con un'accuratezza del 92%. Efficienza del training dei modelli migliorata di 5 volte grazie al training distribuito e alla selezione automatica delle feature.
Guida al profilo per data scientist junior
Per i ruoli junior, punta sul percorso di studi, sui tirocini e sui progetti. Metti in risalto le tue solide basi teoriche e le applicazioni pratiche.
Laureato in Data Science con solide basi di machine learning, statistica e ingegneria del software. 2 tirocini completati in aziende tech, con sviluppo e deployment di modelli di ML con Python, TensorFlow e AWS. Partecipante attivo alle competizioni Kaggle, con 3 medaglie e una ricerca pubblicata sull'elaborazione del linguaggio naturale.
Neolaureato magistrale in Data Science con esperienza pratica di machine learning maturata in diversi progetti di ricerca e tirocini. Sviluppo di un modello di previsione del churn dei clienti con un'accuratezza dell'85%, per un risparmio annuo stimato di 200.000 dollari. Ottima conoscenza di Python, R e SQL e capacità dimostrata di imparare rapidamente nuove tecnologie.
Metti in evidenza i corsi e i progetti di ricerca pertinenti
Punta sui tirocini e sui contributi concreti
Mostra i risultati nelle competizioni e i progetti personali
Dimostra la voglia di continuare a imparare
Indica le tecnologie e i framework di ML che hai usato
Crea il tuo CV da data scientist partendo da questo
Usa questo esempio come punto di partenza, poi adatta contenuti, parole chiave e layout all'annuncio a cui ti stai candidando.
Competenze tecniche
La sezione delle competenze tecniche di un data scientist deve mostrare ampiezza e profondità in machine learning, statistica e programmazione, restando compatibile con gli ATS (i software che le aziende usano per filtrare le candidature). Organizza le competenze per area (ML e AI, statistica, programmazione e così via) e indica il livello di padronanza dove serve. Per i ruoli senior, metti in risalto le tecniche di modellazione avanzate e le scelte architetturali insieme alle tecnologie specifiche. Includi sia i metodi statistici tradizionali sia gli approcci di ML più recenti, per dimostrare solide basi teoriche unite all'esperienza pratica. L'obiettivo è dare un quadro completo ma mirato delle tue capacità tecniche, tenendo sempre conto dei requisiti dei ruoli a cui ti candidi. Ricorda di includere sia le competenze tecniche vere e proprie sia gli approcci metodologici, dai linguaggi di programmazione al design sperimentale fino alle pratiche di deployment dei modelli.
Come organizzare le competenze tecniche
Organizza le competenze in categorie chiare e pertinenti per i ruoli di data science:
Machine learning e AI: deep learning, NLP, computer vision, reinforcement learning, analisi delle serie temporali
Statistica e matematica: test statistici, design sperimentale, metodi bayesiani, algebra lineare
Linguaggi di programmazione: Python (PyTorch, TensorFlow, scikit-learn), R (tidyverse, caret), SQL
Big data e cloud: Spark, Hadoop, AWS (SageMaker), GCP (Vertex AI), Azure ML
Visualizzazione dei dati: Tableau, Power BI, Matplotlib, Seaborn, D3.js
MLOps e strumenti: Docker, Git, MLflow, Kubeflow, DVC, Weights & Biases
Competenze tecniche avanzate
Per i ruoli senior, includi competenze tecniche di alto livello che dimostrano una conoscenza approfondita:
Machine learning: progettazione di architetture di modelli, transfer learning, few-shot learning, AutoML
MLOps: monitoraggio dei modelli, A/B test, feature store, model registry
Big data: calcolo distribuito, progettazione di pipeline di dati, stream processing
Ricerca: implementazione di paper, design sperimentale, revisione della letteratura
Pratiche di sviluppo: CI/CD per il ML, code review, documentazione
Soft skill per data scientist
Includi le competenze non tecniche fondamentali per i ruoli di data science:
Comunicazione: data storytelling, scrittura tecnica, presentazioni agli stakeholder
Project management: Agile/Scrum, sprint planning, allocazione delle risorse
Visione di business: analisi del ROI, definizione dei KPI, raccolta dei requisiti
Leadership: mentoring del team, collaborazione interfunzionale, pianificazione dei progetti
Problem solving: verifica delle ipotesi, analisi delle cause profonde, progettazione delle soluzioni
Esperienza lavorativa
La sezione esperienza lavorativa deve mostrare una crescita nella complessità tecnica e nell'impatto sul business, attraverso risultati concreti e quantificabili. Ogni ruolo deve dimostrare che sai trasformare ciò che emerge dai dati in valore per il business, mettendo in evidenza le tue competenze di machine learning e analytics. Punta sui progetti che hai seguito dall'inizio alla fine, dalla definizione del problema al deployment e al monitoraggio dei modelli. Includi dettagli sulla quantità di dati elaborati, sulle metriche di performance dei modelli e sull'impatto ottenuto sul business. Dimostra che sai lavorare sull'intero ciclo di vita del machine learning, dalla raccolta e preparazione dei dati al deployment e alla manutenzione dei modelli. Per ogni ruolo, indica non solo quali tecnologie hai usato, ma anche perché le hai scelte e quali risultati hanno prodotto.
Esempio di esperienza per un ruolo senior
Per i ruoli senior, metti in risalto la leadership, la responsabilità dei progetti dall'inizio alla fine e l'impatto sul business.
Senior data scientist | AI Solutions Inc. | 2020-oggi
Lead data scientist per una piattaforma di customer intelligence al servizio di clienti Fortune 500
- Progettazione e deployment di un sistema di raccomandazione che elabora oltre 10 milioni di interazioni utente al giorno, con un miglioramento del CTR del 45%
- Guida di un team di 5 data scientist nello sviluppo di un modello di segmentazione dei clienti che ha aumentato dell'85% il ROI del marketing
- Introduzione di una pipeline di ML automatizzata che ha ridotto il tempo di training dei modelli da 1 settimana a 6 ore
- Sviluppo di un sistema di rilevamento delle anomalie in tempo reale con un'accuratezza del 96% nella prevenzione delle frodi
- Definizione di pratiche MLOps che hanno ridotto del 60% i tempi di deployment dei modelli
Tecnologie: Python, TensorFlow, AWS SageMaker, Spark, MLflow, Docker
Esempio di esperienza per un ruolo intermedio
Per i ruoli di livello intermedio, punta sulla realizzazione dei progetti e su un impatto tecnico in crescita.
Data scientist | StartupTech | 2018-2020
Data scientist per una piattaforma di analisi predittiva
- Sviluppo e deployment di un modello di previsione del churn dei clienti con un'accuratezza dell'88%
- Sviluppo di una pipeline NLP che elabora oltre 100.000 recensioni di clienti al mese
- Introduzione di un framework di A/B test che ha aumentato del 300% la velocità di sperimentazione
- Creazione di una pipeline automatizzata di feature engineering che ha ridotto del 50% i tempi di sviluppo dei modelli
- Collaborazione con il team di ingegneria per portare in produzione 5 modelli di ML
Competenze chiave: Python, scikit-learn, NLP, A/B test, feature engineering
Machine learning engineer | Tech Solutions | 2016-2018
ML engineer per sistemi di raccomandazione
- Sviluppo di un motore di raccomandazione che ha aumentato del 35% il coinvolgimento degli utenti
- Ottimizzazione della pipeline di training dei modelli, con una riduzione dei costi del 40%
- Introduzione di un'API di previsione in tempo reale che gestisce oltre 10.000 richieste al secondo
- Sviluppo di un sistema di monitoraggio della qualità dei dati che ha ridotto del 70% i problemi sui dati
Focus principale: sistemi di raccomandazione, deployment dei modelli, sviluppo di API
Progetti e risultati tecnici
La sezione progetti deve mostrare che sai risolvere problemi complessi di data science e ottenere un impatto misurabile sul business. Ogni progetto deve raccontare una storia completa: il problema di business affrontato, l'approccio tecnico scelto, le decisioni di modellazione prese e i risultati quantificabili ottenuti. Scegli progetti che dimostrano competenza in aree pertinenti come machine learning, analisi statistica e data engineering. Includi sia progetti professionali sia progetti personali che mostrano iniziativa e creatività tecnica. Per ogni progetto, descrivi l'intero ciclo di vita del machine learning: preparazione dei dati, scelta del modello, strategia di validazione e scelte per il deployment. Questa sezione deve mostrare non solo cosa hai costruito, ma anche come hai affrontato sfide analitiche complesse e cosa hai imparato.
Come presentare un progetto
Ogni progetto deve comunicare con chiarezza il problema risolto, la metodologia usata e i risultati quantificabili.
Sistema di previsione del churn dei clienti
Problema: un alto tasso di abbandono dei clienti causava una perdita di ricavi di oltre 2 milioni di dollari all'anno
- Sviluppo di un modello ensemble di ML con un'accuratezza dell'88% nella previsione del churn
- Introduzione di una pipeline automatizzata di feature engineering su oltre 50 metriche di comportamento dei clienti
- Riduzione del 35% del churn grazie a interventi mirati
- Deployment del modello tramite API REST, con oltre 10.000 previsioni al giorno
Tecnologie: Python, scikit-learn, XGBoost, FastAPI, PostgreSQL
Analisi del sentiment di mercato in tempo reale
Problema: l'elaborazione manuale dei dati sul sentiment di mercato ritardava le decisioni di trading
- Sviluppo di una pipeline NLP che elabora oltre 100.000 notizie finanziarie al giorno
- Accuratezza del 92% nella classificazione del sentiment con un modello basato su BERT
- Latenza dell'analisi del sentiment ridotta da ore a secondi
- Introduzione di un'architettura di streaming per analisi di mercato in tempo reale
Tecnologie: Python, PyTorch, Kafka, Elasticsearch, Docker
Risultati nella ricerca e nelle competizioni
Metti in evidenza la ricerca accademica e i successi nelle competizioni di data science.
Pubblicazioni: «Novel Approaches to Few-Shot Learning in Computer Vision», oltre 100 citazioni
Competizioni Kaggle: 2 medaglie d'oro in sfide di NLP, nel top 1% della classifica
Brevetto in attesa di concessione: «Metodo efficiente per il rilevamento in tempo reale di anomalie in serie temporali»
Open source: creazione di una libreria di data augmentation molto usata, con oltre 10.000 stelle su GitHub
Riconoscimenti: Best Paper Award alla ML Conference 2023
Istruzione e certificazioni tecniche
Per un data scientist, la sezione istruzione deve valorizzare sia le basi teoriche sia le applicazioni pratiche. Metti in evidenza i corsi pertinenti di statistica, machine learning e informatica. Per i titoli avanzati, indica i lavori di ricerca e le pubblicazioni che dimostrano competenza in domini specifici. Scegli con cura le certificazioni tecniche, per mostrare padronanza degli strumenti e delle piattaforme standard del settore. Includi non solo il nome delle certificazioni, ma anche i progetti o le implementazioni importanti nati da queste conoscenze. Ricorda di mettere in evidenza i progetti accademici con analisi di dati reali, collaborazioni con partner aziendali o applicazioni innovative del machine learning. Questa sezione deve dimostrare sia la tua preparazione teorica sia la tua capacità di applicare concetti analitici avanzati a problemi concreti.
Come presentare l'istruzione
Presenta il tuo percorso di studi mettendo in risalto i corsi e la ricerca pertinenti.
Dottorato di ricerca in Machine Learning | Tech University | 2018-2022 • Tesi di dottorato: «Tecniche avanzate di self-supervised learning per la computer vision» • 3 articoli pubblicati in conferenze di ML di primo livello (NeurIPS, ICML) • Ambiti di ricerca: deep learning, computer vision, transfer learning • Progetti principali: - Sviluppo di un nuovo algoritmo di few-shot learning con risultati allo stato dell'arte (SOTA) - Creazione di tecniche efficienti di data augmentation per dataset limitati - Collaborazione con partner aziendali su applicazioni di ML nel mondo reale
Laurea magistrale in Data Science | State University | 2016-2018 • Media (GPA): 3,95/4,0 • Corsi pertinenti: machine learning avanzato, teoria dell'apprendimento statistico, deep learning • Tesi: «Metodi efficienti per l'analisi di serie temporali su larga scala» • Riconoscimenti: Outstanding Graduate Research Award, Data Science Fellowship
Certificazioni professionali
Elenca le certificazioni che dimostrano competenza nelle tecnologie e nelle metodologie pertinenti.
Certificazione AWS Machine Learning Specialty
Google Cloud Professional Data Engineer
TensorFlow Developer Certificate
Databricks Certified Machine Learning Professional
Deep Learning Specialization di deeplearning.ai
Ottimizzazione e formattazione del CV
Il CV di un data scientist deve bilanciare profondità tecnica e chiarezza, restando leggibile sia per gli ATS sia per le persone. Servono una formattazione studiata e parole chiave specifiche per i ruoli di data science. Usa titoli di sezione standard e inserisci in modo naturale i termini di machine learning e statistica pertinenti in tutto il CV. Il layout deve accompagnare il lettore lungo il tuo percorso nella data science, mantenendo le informazioni importanti facili da scorrere. Tieni conto del background tecnico di chi ti legge: includi abbastanza dettagli da dimostrare la tua competenza, ma con descrizioni comprensibili anche ai recruiter non tecnici. Cura la coerenza della formattazione, soprattutto per i termini tecnici e le metriche. Usa un font pulito e professionale e lascia abbastanza spazio bianco per facilitare la lettura. Ricorda di includere i link al tuo profilo GitHub, al tuo account Kaggle o alle tue pubblicazioni, formattati bene sia per la versione digitale sia per quella stampata.
Ottimizzazione per gli ATS nei ruoli di data science
Assicurati che il tuo CV superi i filtri degli ATS e resti facile da leggere.
Includi i termini chiave di ML e AI presenti negli annunci di lavoro (ad esempio «machine learning», «deep learning», «reti neurali»)
Usa titoli di sezione standard (Esperienza lavorativa, Competenze, Istruzione)
Scrivi le sigle per esteso almeno una volta (ad esempio «elaborazione del linguaggio naturale (NLP)»)
Evita tabelle e formattazioni complesse che possono confondere gli ATS
Includi sia i nomi degli strumenti sia i concetti (ad esempio «PyTorch», «reti neurali convoluzionali»)
Indica le certificazioni sia per esteso sia in forma abbreviata (ad esempio «AWS Certified Solutions Architect - Associate (AWS-SAA)»)
Buone pratiche per il CV di un data scientist
Formatta il CV in modo da mettere in risalto le tue competenze analitiche e tecniche.
Apri con metriche d'impatto (accuratezza, miglioramenti delle performance, impatto sul business)
Includi i link agli articoli pubblicati, ai repository GitHub e ai profili Kaggle
Organizza i progetti per tipo (ML engineering, ricerca, analytics)
Metti in evidenza sia le competenze tecniche sia l'impatto sul business
Usa poca notazione matematica e rendila chiara
Usa una formattazione coerente per le metriche di performance dei modelli
Errori comuni nei CV di data science
Evita questi errori frequenti nei CV di data science:
Elencare algoritmi senza mostrarne le applicazioni pratiche
Concentrarsi sugli strumenti invece che sul modo di risolvere i problemi
Non spiegare l'impatto dei modelli sul business
Usare troppo gergo tecnico nel profilo professionale
Omettere le metriche di performance dei modelli e le strategie di validazione
Non dimostrare di aver seguito i progetti dall'inizio alla fine


















Rendi la tua esperienza impossibile da ignorare.
Crea un CV compatibile con gli ATS e su misura per l'offerta, aggiungi una lettera di presentazione abbinata e sii pronto a candidarti in pochi minuti.
4,58/5
49.000+ candidati
Inizia gratis · Nessuna carta di credito richiesta