Data Scientist: uitgebreide gids voor je cv
Bekijk dit cv-voorbeeld voor een data scientist. Maak daarna met AI een versie voor jouw vacature of controleer de score van je huidige cv.
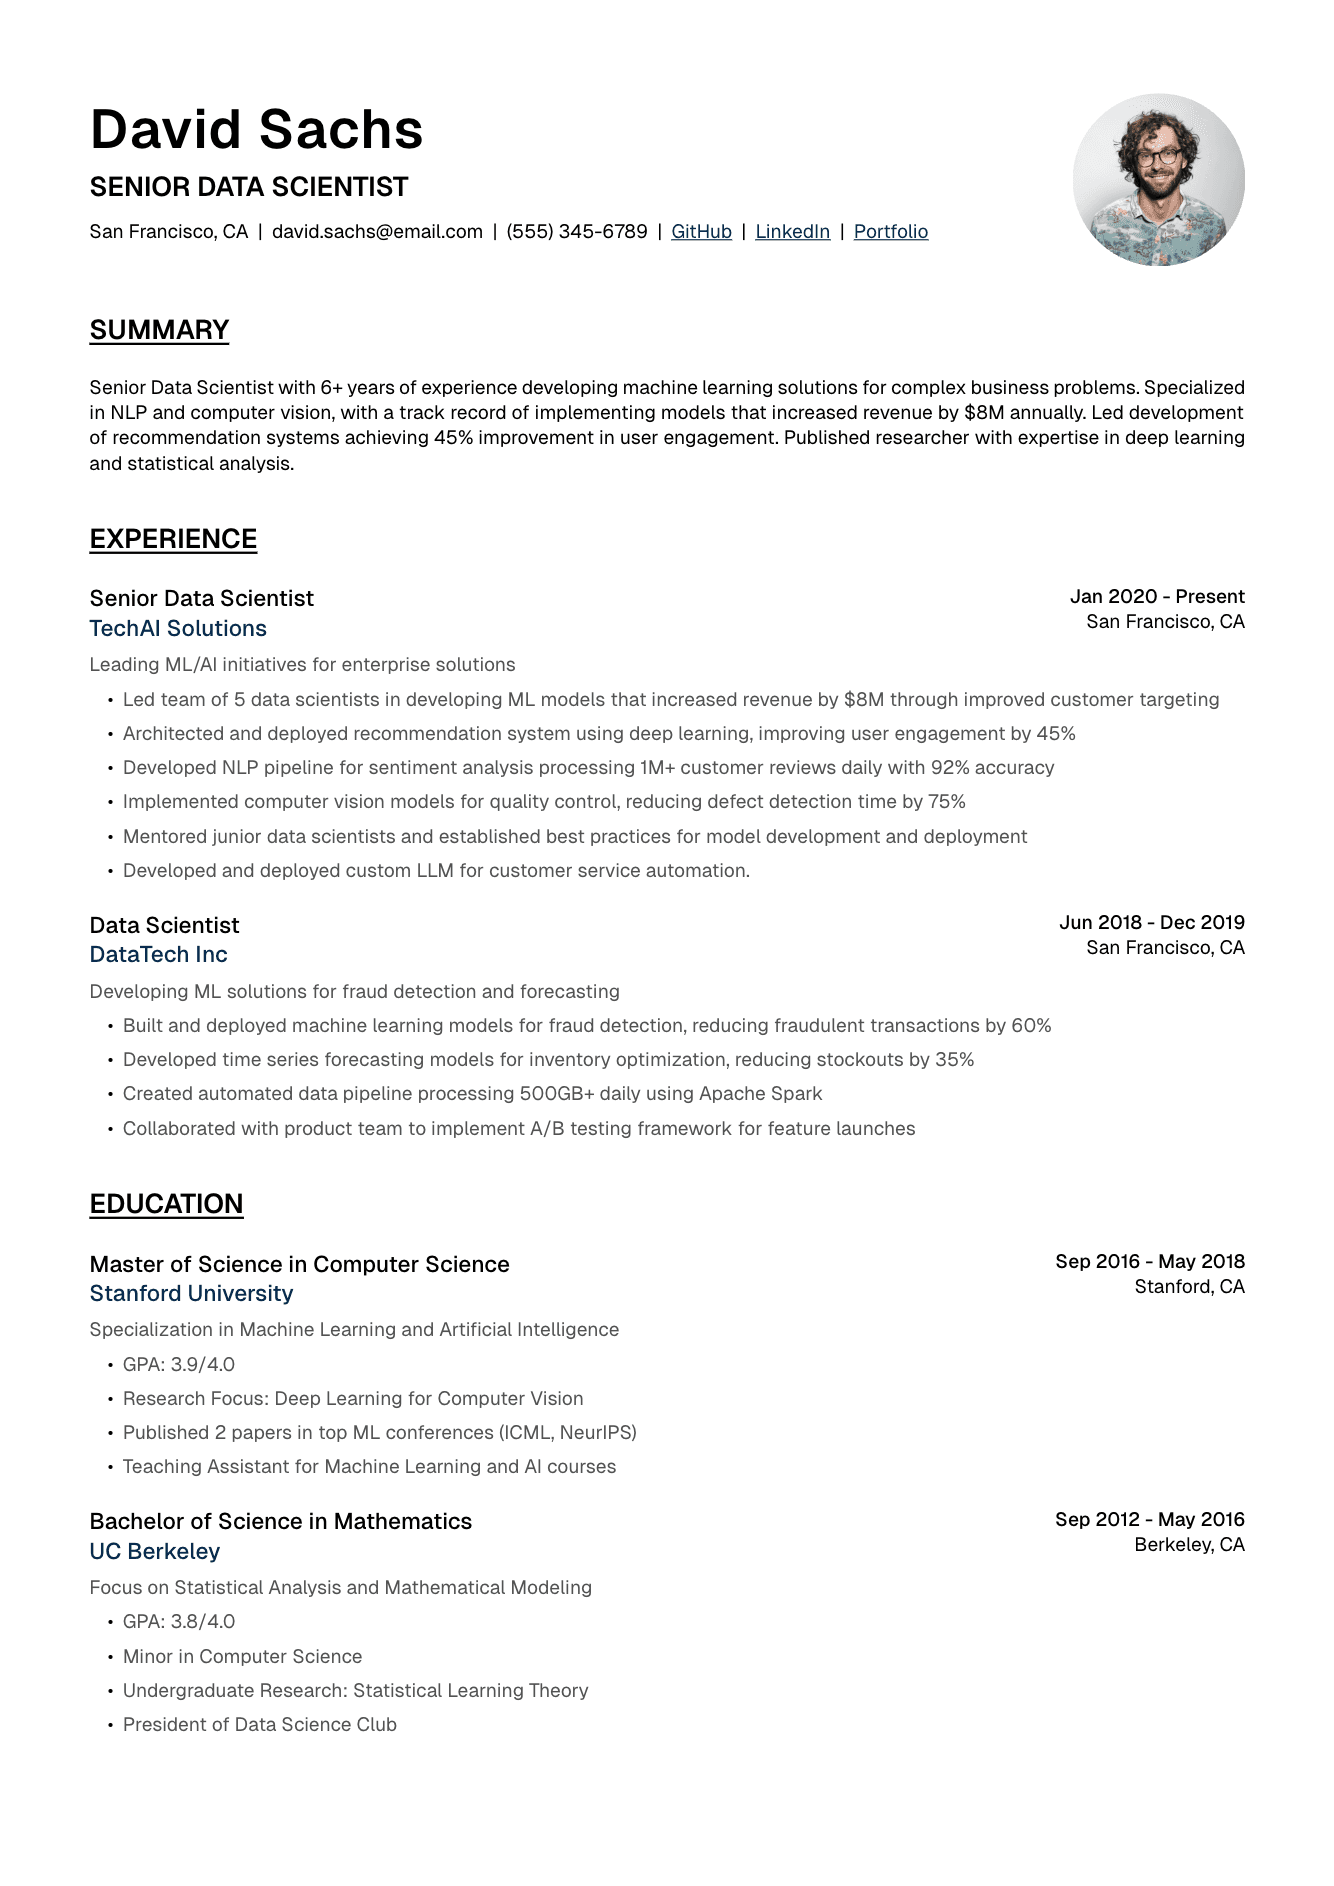
Samenvatting voor data scientists
Je samenvatting als data scientist moet technische expertise en zakelijk inzicht in balans brengen, en meteen laten zien dat je uit complexe data bruikbare inzichten haalt. Deze sectie moet de aandacht trekken met je meest impactvolle projecten, je kennis van modelleren en de zakelijke waarde die je aantoonbaar hebt gecreëerd. Voor seniorfuncties leg je de nadruk op machine-learningsystemen die je in productie hebt gebracht en teams die je hebt geleid; voor functies op medior niveau op geslaagde modellen en analyses; voor startersfuncties op een sterke theoretische basis en praktische projecten. Onderbouw je resultaten met concrete cijfers en houd het helder. Stem deze sectie af op de functie en de branche, en noem relevante domeinen en technische specialismen. De samenvatting laat niet alleen zien wat je technisch kunt, maar ook hoe je analyses en modellen zakelijke beslissingen en verbeteringen hebben opgeleverd.
Samenvatting voor senior data scientists
Voor seniorfuncties draait je samenvatting om drie dingen: technisch leiderschap in machine learning, verantwoordelijkheid voor projecten van begin tot eind en zakelijke impact. Noem modellen in productie, teams die je hebt geleid en concrete verbeteringen.
Senior Data Scientist met 8+ jaar ervaring in het ontwikkelen en op grote schaal uitrollen van machine-learningoplossingen. Leiding gegeven aan de ontwikkeling van een aanbevelingssysteem dat via hogere gebruikersbetrokkenheid ruim $50 mln extra omzet opleverde. Expert in deep learning en NLP, met aantoonbare ervaring in het coachen van teams en het invoeren van MLOps-werkwijzen die de uitroltijd van modellen met 70% verkortten.
Principal Data Scientist, gespecialiseerd in computer vision en deep learning. 10+ jaar ervaring met het leiden van grootschalige AI-initiatieven, waaronder de ontwikkeling van een realtime objectdetectiesysteem dat dagelijks 1 mln+ afbeeldingen verwerkt met 98% nauwkeurigheid. Expertise in PyTorch, TensorFlow en gedistribueerde training; de trainingskosten van modellen jaarlijks met $300.000 verlaagd.
Begin met je hoogste functietitel en je aantal jaren ervaring
Noem de ML-domeinen en technologieën waarin je uitblinkt
Onderbouw je impact met concrete cijfers (omzetstijging, hogere nauwkeurigheid)
Laat zowel productresultaten als leiderschap zien
Houd het onder de 4 regels, dan leest het het best
Samenvatting voor data scientists op medior niveau
Op medior niveau leg je de nadruk op geslaagde projecten en je groeiende technische expertise. Laat zien dat je projecten van begin tot eind draagt en welke technische problemen je hebt opgelost.
Data Scientist met 4 jaar ervaring in machine-learningoplossingen voor de financiële sector. Fraudedetectiemodel ontworpen en in productie gebracht dat dagelijks ruim $100 mln aan transacties verwerkt met 99,5% nauwkeurigheid. Fout-positieven met 40% verminderd met vernieuwende feature engineering en ensemblemodellen.
Machine Learning Engineer met 3 jaar ervaring, gespecialiseerd in NLP en tekstanalyse. Leiding gegeven aan de ontwikkeling van een sentimentanalysepipeline die maandelijks 1 mln+ klantreviews verwerkt met 92% nauwkeurigheid. Trainingsefficiëntie van modellen 5x verbeterd met gedistribueerde training en geautomatiseerde featureselectie.
Samenvatting voor beginnende data scientists
Voor startersfuncties richt je je op je opleiding, stages en projecten. Leg de nadruk op je sterke theoretische basis en de praktische toepassing ervan.
Afgestudeerd in data science, met een sterke basis in machine learning, statistiek en software engineering. 2 stages gelopen bij techbedrijven: ML-modellen ontwikkeld en uitgerold met Python, TensorFlow en AWS. Actief op Kaggle met 3 medailles in competities en gepubliceerd onderzoek in natural language processing.
Pas afgestudeerd met een master in data science, met praktijkervaring in machine learning uit meerdere onderzoeksprojecten en stages. Model voor het voorspellen van klantverloop ontwikkeld met 85% nauwkeurigheid, goed voor een verwachte jaarlijkse besparing van $200.000. Vaardig in Python, R en SQL, met aantoonbaar vermogen om nieuwe technologieën snel onder de knie te krijgen.
Noem relevante vakken en onderzoeksprojecten
Leg de nadruk op je stages en je concrete bijdragen
Laat resultaten in competities en eigen projecten zien
Toon dat je graag blijft leren
Noem de technologieën en ML-frameworks die je hebt gebruikt
Maak je cv als data scientist naar dit voorbeeld
Gebruik dit voorbeeld als startpunt en stem daarna de inhoud, zoekwoorden en lay-out af op de vacaturetekst van de functie waarop je solliciteert.
Technische vaardigheden
De sectie technische vaardigheden van een data scientist laat zowel breedte als diepgang zien in machine learning, statistiek en programmeren, en moet goed leesbaar zijn voor het ATS. Orden je vaardigheden per domein (ML/AI, statistiek, programmeren enzovoort) en geef waar nuttig je niveau aan. Voor seniorfuncties leg je naast specifieke technologieën de nadruk op geavanceerde modelleertechnieken en architectuurkeuzes. Noem zowel klassieke statistische methodes als moderne ML-technieken, zodat je een sterke theoretische basis én praktische expertise laat zien. Het doel is een compleet maar gericht beeld van je technische kunnen, steeds afgestemd op de eisen van de functies waarop je solliciteert. Noem zowel technische hard skills als methodes, van specifieke programmeertalen tot experimentontwerp en het uitrollen van modellen.
Technische vaardigheden ordenen
Orden je vaardigheden in duidelijke categorieën die voor data science tellen:
Machine learning/AI: deep learning, NLP, computer vision, reinforcement learning, tijdreeksanalyse
Statistiek en wiskunde: statistische toetsen, experimentontwerp, Bayesiaanse methodes, lineaire algebra
Programmeertalen: Python (PyTorch, TensorFlow, scikit-learn), R (tidyverse, caret), SQL
Big data en cloud: Spark, Hadoop, AWS (SageMaker), GCP (Vertex AI), Azure ML
Datavisualisatie: Tableau, Power BI, Matplotlib, Seaborn, D3.js
MLOps en tools: Docker, Git, MLflow, Kubeflow, DVC, Weights & Biases
Gevorderde technische competenties
Voor seniorfuncties noem je technische competenties die diepgaande expertise laten zien:
Machine learning: ontwerp van modelarchitecturen, transfer learning, few-shot learning, AutoML
MLOps: modelmonitoring, A/B-testen, feature stores, model registry
Big data: gedistribueerd rekenen, ontwerp van datapipelines, streamverwerking
Onderzoek: implementatie van papers, experimentontwerp, literatuuronderzoek
Ontwikkelpraktijk: CI/CD voor ML, code reviews, documentatie
Soft skills voor data scientists
Noem de niet-technische vaardigheden die in data science onmisbaar zijn:
Communicatie: data storytelling, technisch schrijven, presentaties voor stakeholders
Projectmanagement: Agile/Scrum, sprintplanning, toewijzing van middelen
Zakelijk inzicht: ROI-analyse, KPI's bepalen, requirements verzamelen
Leiderschap: teamcoaching, samenwerking tussen afdelingen, projectplanning
Probleemoplossing: hypothesetoetsing, oorzaakanalyse, oplossingsontwerp
Werkervaring
Je werkervaring moet met concrete, meetbare prestaties laten zien dat je bent gegroeid in technische complexiteit en zakelijke impact. Elke functie laat zien dat je inzichten uit data omzet in zakelijke waarde, en toont je technische expertise in machine learning en analytics. Leg de nadruk op projecten die je van begin tot eind droeg, van de probleemdefinitie tot het uitrollen en monitoren van modellen. Noem de hoeveelheid verwerkte data, de prestaties van je modellen en de behaalde zakelijke impact. Laat zien dat je de hele machine-learningcyclus beheerst, van dataverzameling en preprocessing tot het uitrollen en onderhouden van modellen. Noem per functie niet alleen welke technologieën je gebruikte, maar ook waarom je ze koos en wat ze opleverden.
Voorbeeld werkervaring in een seniorfunctie
Voor seniorfuncties leg je de nadruk op leiderschap, projecten van begin tot eind en zakelijke impact.
Senior Data Scientist | AI Solutions Inc. | 2020-heden
Lead data scientist voor een customer-intelligenceplatform voor Fortune 500-klanten
- Aanbevelingssysteem ontworpen en in productie gebracht dat dagelijks 10 mln+ gebruikersinteracties verwerkt, met 45% hogere CTR
- Team van 5 data scientists geleid bij de ontwikkeling van een klantsegmentatiemodel dat de marketing-ROI met 85% verhoogde
- Geautomatiseerde ML-pipeline ingevoerd die de trainingstijd van modellen terugbracht van 1 week naar 6 uur
- Realtime systeem voor anomaliedetectie ontwikkeld met 96% nauwkeurigheid in fraudepreventie
- MLOps-werkwijzen ingevoerd die de uitroltijd van modellen met 60% verkortten
Technologieën: Python, TensorFlow, AWS SageMaker, Spark, MLflow, Docker
Voorbeeld werkervaring op medior niveau
Op medior niveau richt je je op de uitvoering van projecten en je groeiende technische impact.
Data Scientist | StartupTech | 2018-2020
Data scientist voor een platform voor voorspellende analyses
- Model voor het voorspellen van klantverloop gebouwd en in productie gebracht met 88% nauwkeurigheid
- NLP-pipeline ontwikkeld die maandelijks 100.000+ klantreviews verwerkt
- Framework voor A/B-testen ingevoerd waardoor het tempo van experimenten met 300% steeg
- Geautomatiseerde pipeline voor feature engineering opgezet die de ontwikkeltijd van modellen met 50% verkortte
- Met het engineeringteam 5 ML-modellen in productie gebracht
Belangrijkste vaardigheden: Python, scikit-learn, NLP, A/B-testen, feature engineering
Machine Learning Engineer | Tech Solutions | 2016-2018
ML-engineer voor aanbevelingssystemen
- Aanbevelingssysteem gebouwd dat de gebruikersbetrokkenheid met 35% verhoogde
- Trainingspipeline van modellen geoptimaliseerd, waardoor de kosten met 40% daalden
- Realtime voorspellings-API ingevoerd die 10.000+ verzoeken per seconde verwerkt
- Systeem voor het monitoren van datakwaliteit ontwikkeld dat dataproblemen met 70% verminderde
Focus: aanbevelingssystemen, uitrol van modellen, API-ontwikkeling
Projecten en technische prestaties
Je projecten laten zien dat je complexe problemen in data science oplost en meetbare zakelijke impact levert. Elk project vertelt een compleet verhaal: het zakelijke probleem, de technische aanpak, de keuzes bij het modelleren en de meetbare resultaten. Kies projecten die expertise laten zien in relevante gebieden zoals machine learning, statistische analyse en data engineering. Noem zowel projecten uit je werk als eigen projecten die initiatief en technische creativiteit tonen. Beschrijf per project de hele machine-learningcyclus, met datavoorbereiding, modelkeuze, validatiestrategie en afwegingen bij de uitrol. Deze sectie laat niet alleen zien wat je hebt gebouwd, maar ook hoe je complexe analytische vraagstukken aanpakte en wat je ervan leerde.
Je projecten presenteren
Elk project maakt duidelijk welk probleem je oploste, welke methode je gebruikte en wat de meetbare resultaten waren.
Systeem voor het voorspellen van klantverloop
Probleem: hoog klantverloop, goed voor ruim $2 mln omzetverlies per jaar
- Ensemble-ML-model ontwikkeld dat klantverloop met 88% nauwkeurigheid voorspelt
- Geautomatiseerde pipeline voor feature engineering ingevoerd die 50+ kengetallen over klantgedrag verwerkt
- Klantverloop met 35% verminderd met gerichte interventies
- Model uitgerold via een REST-API die dagelijks 10.000+ voorspellingen verwerkt
Technologieën: Python, scikit-learn, XGBoost, FastAPI, PostgreSQL
Realtime sentimentanalyse van de markt
Probleem: handmatige verwerking van marktsentiment zorgde voor vertraagde handelsbeslissingen
- NLP-pipeline gebouwd die dagelijks 100.000+ financiële nieuwsartikelen verwerkt
- 92% nauwkeurigheid behaald in sentimentclassificatie met een op BERT gebaseerd model
- Doorlooptijd van sentimentanalyse teruggebracht van uren naar seconden
- Streamingarchitectuur ingevoerd voor realtime marktinzichten
Technologieën: Python, PyTorch, Kafka, Elasticsearch, Docker
Resultaten in onderzoek en competities
Noem je academisch onderzoek en successen in data-sciencecompetities.
Gepubliceerd onderzoek: “Novel Approaches to Few-Shot Learning in Computer Vision”, 100+ keer geciteerd
Kaggle-competities: 2 gouden medailles in NLP-challenges, top 1% van de ranglijst
Patent aangevraagd: “Efficient Method for Real-time Anomaly Detection in Time Series Data”
Open source: populaire library voor data-augmentatie gemaakt met 10.000+ sterren op GitHub
Erkenning in het vak: Best Paper Award op ML Conference 2023
Opleiding en technische certificeringen
In de sectie opleiding van een data scientist horen zowel je theoretische basis als de praktische toepassing. Noem relevante vakken in statistiek, machine learning en informatica. Bij een vervolgopleiding noem je onderzoek en publicaties die je expertise in een bepaald domein laten zien. Kies technische certificeringen die laten zien dat je de gangbare tools en platforms beheerst. Noem niet alleen de naam van de certificering, maar ook belangrijke projecten of toepassingen die uit die kennis voortkwamen. Noem ook studieprojecten met echte data-analyse, samenwerkingen met bedrijven of vernieuwende toepassingen van machine learning. Deze sectie laat zowel je theoretisch begrip zien als je vermogen om geavanceerde analytische concepten op praktische problemen toe te passen.
Je opleiding presenteren
Presenteer je opleiding met de nadruk op relevante vakken en onderzoek.
Ph.D. Machine Learning | Tech University | 2018-2022 • Proefschrift: “Advanced Techniques in Self-Supervised Learning for Computer Vision” • 3 papers gepubliceerd op toonaangevende ML-congressen (NeurIPS, ICML) • Onderzoeksfocus: deep learning, computer vision, transfer learning • Belangrijkste projecten: - Nieuw few-shot-learningalgoritme ontwikkeld met SOTA-resultaten - Efficiënte technieken voor data-augmentatie ontwikkeld voor beperkte datasets - Met bedrijfspartners samengewerkt aan ML-toepassingen in de praktijk
Master of Science Data Science | State University | 2016-2018 • GPA (gemiddeld cijfer): 3,95/4,0 • Relevante vakken: Advanced Machine Learning, Statistical Learning Theory, Deep Learning • Scriptie: “Efficient Methods for Large-Scale Time Series Analysis” • Prijzen: Outstanding Graduate Research Award, Data Science Fellowship
Beroepscertificeringen
Noem certificeringen die je expertise in relevante technologieën en methodes aantonen.
AWS Machine Learning Specialty Certification
Google Cloud Professional Data Engineer
TensorFlow Developer Certificate
Databricks Certified Machine Learning Professional
Deep Learning Specialization, deeplearning.ai
Je cv optimaliseren en opmaken
Het cv van een data scientist moet technische diepgang combineren met helderheid, en zowel door het ATS als door mensen goed te lezen zijn. Dat vraagt om een doordachte opmaak en zoekwoorden die passen bij functies in data science. Gebruik gangbare sectiekoppen en verwerk relevante termen uit machine learning en statistiek op een natuurlijke manier in je cv. De lay-out leidt de lezer door je groei in data science, terwijl de belangrijkste informatie snel te scannen blijft. Houd rekening met de technische achtergrond van je lezer: geef genoeg detail om je expertise te tonen, maar houd beschrijvingen begrijpelijk voor recruiters zonder technische kennis. Let goed op consistente opmaak, vooral bij technische termen en cijfers. Kies een strak, professioneel lettertype en laat genoeg witruimte voor de leesbaarheid. Vergeet niet links naar je GitHub-profiel, Kaggle-account of publicaties op te nemen, en zorg dat ze zowel digitaal als op papier goed werken.
ATS-optimalisatie voor functies in data science
Zorg dat je cv door het ATS komt en goed leesbaar blijft.
Neem belangrijke ML/AI-termen uit vacatureteksten over (bijvoorbeeld “machine learning”, “deep learning”, “neurale netwerken”)
Gebruik gangbare sectiekoppen (Werkervaring, Vaardigheden, Opleiding)
Schrijf afkortingen minstens één keer voluit (bijvoorbeeld “Natural Language Processing (NLP)”)
Vermijd tabellen en ingewikkelde opmaak die het ATS in de war kunnen brengen
Noem zowel toolnamen als concepten (bijvoorbeeld “PyTorch”, “convolutionele neurale netwerken”)
Vermeld certificeringen voluit en afgekort (bijvoorbeeld “AWS Certified Solutions Architect, Associate (AWS-SAA)”)
Best practices voor een cv in data science
Maak je cv op zodat je analytische en technische expertise goed naar voren komen.
Begin met sprekende cijfers (nauwkeurigheid, prestatieverbeteringen, zakelijke impact)
Neem links op naar gepubliceerde papers, GitHub-repositories en Kaggle-profielen
Orden projecten per type (ML-engineering, onderzoek, analytics)
Laat zowel technische vaardigheden als zakelijke impact zien
Houd wiskundige notatie beperkt en helder
Gebruik een consistente opmaak voor de prestatiecijfers van modellen
Veelgemaakte fouten in een cv voor data science
Vermijd deze veelvoorkomende valkuilen in een cv voor data science:
Algoritmes opsommen zonder praktische toepassingen te laten zien
De nadruk leggen op tools in plaats van op je aanpak bij het oplossen van problemen
Niet uitleggen wat je modellen zakelijk hebben opgeleverd
Te veel technisch jargon gebruiken in een samenvatting voor het management
Prestatiecijfers en validatiestrategieën van modellen weglaten
Niet laten zien dat je projecten van begin tot eind hebt gedragen


















Laat je ervaring direct opvallen.
Maak een ATS-vriendelijk cv dat is afgestemd op de vacature, voeg een bijpassende sollicitatiebrief toe en ben binnen enkele minuten klaar om te solliciteren.
4,58/5
49.000+ sollicitanten
Gratis starten · Geen creditcard nodig